Kelaskan risiko kredit dengan Pengekstrakan Ciri Kuantum Rimay Kipu Quantum
Qiskit Functions ialah ciri eksperimen yang hanya tersedia kepada pengguna Pelan Premium, Pelan Flex, dan Pelan On-Prem (melalui API IBM Quantum Platform) IBM Quantum®. Ia berstatus keluaran pratonton dan tertakluk kepada perubahan.
Anggaran penggunaan: 2 minit pada pemproses Nighthawk r2. (NOTA: Ini hanyalah anggaran. Masa jalan anda mungkin berbeza.)
Hasil pembelajaran
-
Sediakan data jadual dengan lajur kategori dan berangka untuk Qiskit Function Rimay.
-
Padankan pemetaan ciri kuantum pada data latihan dan petakan data ujian dalam larian yang sama.
-
Latih model klasik pada ciri yang ditransformasi secara kuantum, secara bersendirian dan digabungkan dengan ciri asal.
-
Bandingkan keputusan dengan garis dasar klasik sepenuhnya.
Prasyarat
Sebelum anda memulakan tutorial ini, anda sepatutnya biasa dengan topik berikut:
-
Pengelasan terselia dengan scikit-learn
Latar belakang
Banyak masalah pembelajaran mesin dalam industri melibatkan set data jadual bersaiz kecil atau sederhana, di mana menambah lebih banyak data bukan satu pilihan dan ketepatan model mencapai dataran. Pemarkahan risiko kredit ialah contoh biasa. Pemberi pinjaman menggunakan beberapa dozen atribut untuk memutuskan sama ada pemohon berkemungkinan membayar balik kredit itu.
Rimay, sebuah Qiskit Function oleh Kipu Quantum, menambah langkah prapemprosesan kuantum pada saluran paip sedemikian. Ia melaksanakan algoritma pengekstrakan ciri kuantum kontradiabatik didigitkan [1]. Setiap ciri input dipetakan kepada satu qubit. Nilai ciri dan maklumat bersama antara ciri menetapkan medan setempat dan gandingan Hamiltonian kaca-spin. Dinamik kontradiabatik kemudian mengembangkan sistem kuantum ke arah keadaan bertenaga rendahnya, dan nilai jangkaan satu-badan dan dua-badan yang diukur pada akhirnya menjadi ciri baharu yang ditransformasi secara kuantum. Ciri ini menangkap korelasi tak linear antara input, dan anda boleh menyuapkannya kepada mana-mana model klasik.
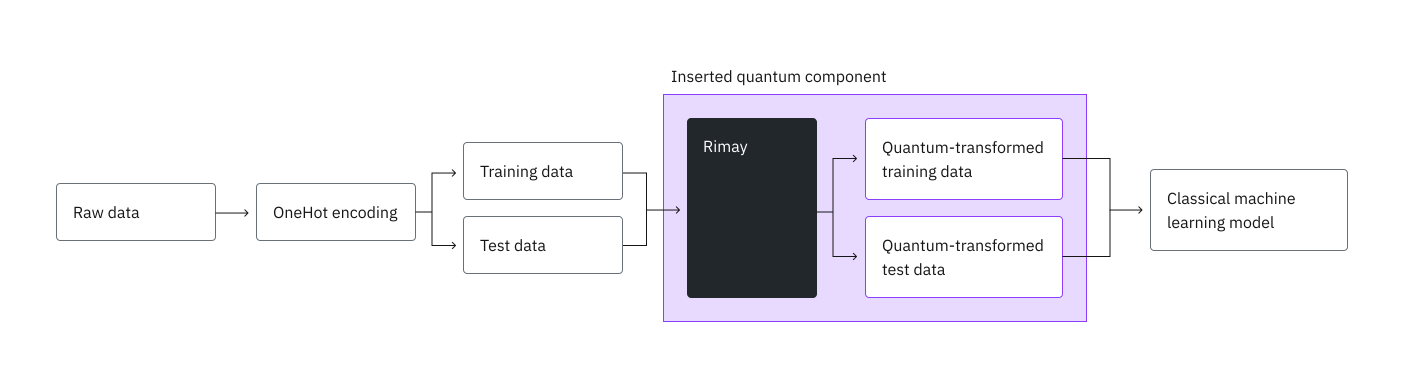
Tutorial ini menggunakan set data kredit Jerman daripada OpenML [2], dengan 1000 pemohon dan 20 atribut, untuk melatih pengelas hutan rawak. Anda mula-mula menubuhkan garis dasar klasik, kemudian menghantar data kepada Rimay, dan akhirnya melatih jenis model yang sama pada ciri yang ditransformasi secara kuantum, secara bersendirian dan digabungkan dengan ciri asal.
Keperluan
Sebelum anda memulakan tutorial ini, pastikan anda telah memasang pakej berikut:
-
Klien IBM Quantum Compute (
pip install qiskit-ibm-runtime) -
Qiskit Functions (
pip install qiskit-ibm-catalog) -
scikit-learn (
pip install scikit-learn) -
pandas (
pip install pandas) -
Matplotlib (
pip install matplotlib)
Anda juga memerlukan akses kepada fungsi Rimay daripada Qiskit Functions Catalog.
Persediaan
Import pakej dan takrifkan dua fungsi pembantu: satu untuk melatih random forest, dan satu lagi untuk mengira metrik yang digunakan sepanjang tutorial ini.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "sklearn": "scikit-learn"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from sklearn.datasets import fetch_openml
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score,
    f1_score,
    precision_score,
    recall_score,
    roc_auc_score,
)
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

def train_random_forest(x, y, n_estimators, max_depth):
    """Train a random forest classifier with fixed hyperparameters."""
    model = RandomForestClassifier(
        n_estimators=n_estimators,
        max_depth=max_depth,
        min_samples_split=5,
        min_samples_leaf=1,
        max_features="sqrt",
        random_state=42,
        n_jobs=-1,
    )
    return model.fit(x, y)

def evaluate(model, x, y):
    """Return the classification metrics of a trained model on a test set."""
    y_pred = model.predict(x)
    y_proba = model.predict_proba(x)[:, 1]
    return {
        "Accuracy": accuracy_score(y, y_pred),
        "AUC": roc_auc_score(y, y_proba),
        "F1 score": f1_score(y, y_pred),
        "Precision": precision_score(y, y_pred),
        "Recall": recall_score(y, y_pred),
    }
Konfigurasikan kelayakan IBM Quantum
Sahkan identiti dengan kunci API IBM Quantum Platform anda, muatkan fungsi Rimay, dan pilih pemproses kuantum paling kurang sibuk yang tersedia untuk instance anda.
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
rimay = catalog.load("kipu-quantum/rimay")

backend = catalog.least_busy(operational=True, simulator=False)
print(backend.name, backend.num_qubits)
ibm_fez 156
Langkah 1: Petakan input klasik kepada masalah kuantum
Rimay memetakan setiap ciri input berangka kepada satu qubit, jadi langkah pertama ialah menukar jadual mentah kepada ciri berangka.
Muatkan set data
Muatkan set data kredit Jerman terus daripada OpenML. Lajur class mengandungi label: good untuk pemohon yang membayar balik kredit mereka dan bad untuk yang tidak.
df = fetch_openml(data_id=31, as_frame=True).frame
print(df.shape)
df.head()
(1000, 21)
checking_status  duration                  credit_history  \
0              <0         6  critical/other existing credit
1        0<=X<200        48                   existing paid
2     no checking        12  critical/other existing credit
3              <0        42                   existing paid
4              <0        24              delayed previously

               purpose  credit_amount    savings_status employment  \
0             radio/tv           1169  no known savings        >=7
1             radio/tv           5951              <100     1<=X<4
2            education           2096              <100     4<=X<7
3  furniture/equipment           7882              <100     4<=X<7
4              new car           4870              <100     1<=X<4

   installment_commitment     personal_status other_parties  ...  \
0                       4         male single          none  ...
1                       2  female div/dep/mar          none  ...
2                       2         male single          none  ...
3                       2         male single     guarantor  ...
4                       3         male single          none  ...

   property_magnitude age  other_payment_plans   housing existing_credits  \
0         real estate  67                 none       own                2
1         real estate  22                 none       own                1
2         real estate  49                 none       own                1
3      life insurance  45                 none  for free                1
4   no known property  53                 none  for free                2

                  job num_dependents  own_telephone foreign_worker class
0             skilled              1            yes            yes  good
1             skilled              1           none            yes   bad
2  unskilled resident              2           none            yes  good
3             skilled              2           none            yes  good
4             skilled              2           none            yes   bad

[5 rows x 21 columns]
Kodkan ciri
Tukarkan label kepada nilai binari, dan kodkan one-hot 13 lajur kategori. Kod ini membuang kategori pertama bagi setiap lajur untuk mengelakkan ciri berlebihan, yang menghasilkan 48 ciri berangka.
y = (df["class"] == "good").astype(int)

features = df.drop(columns="class")
categorical_cols = [
    col for col in features.columns if features[col].dtype.name == "category"
]
encoder = OneHotEncoder(
    sparse_output=False, handle_unknown="ignore", drop="first"
)
encoded = pd.DataFrame(
    encoder.fit_transform(features[categorical_cols]),
    columns=encoder.get_feature_names_out(categorical_cols),
    index=features.index,
)
x = pd.concat([features.drop(columns=categorical_cols), encoded], axis=1)
print(f"{x.shape[1]} features")
48 features
Pisahkan kepada set latihan dan set ujian
Asingkan 20% pemohon sebagai set ujian. Pemisahan berstrata mengekalkan perkadaran kredit baik dan buruk yang sama dalam kedua-dua set.
x_train, x_test, y_train, y_test = train_test_split(
    x, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Training set: {x_train.shape}, test set: {x_test.shape}")
Training set: (800, 48), test set: (200, 48)
Tetapkan garis dasar klasik
Latih random forest pada ciri klasik. Dalam Langkah 4, anda membandingkan ciri yang diubah secara kuantum dengan metriknya.
baseline = train_random_forest(
    x_train, y_train, n_estimators=500, max_depth=12
)
results = {"Classical": evaluate(baseline, x_test, y_test)}
pd.DataFrame(results).T
Accuracy       AUC  F1 score  Precision    Recall
Classical     0.765  0.781071  0.845902   0.781818  0.921429
Muat naik data ke Rimay
Rimay membaca inputnya daripada fail CSV yang anda muat naik ke fungsi tersebut. Ciri dan label disimpan dalam fail berasingan. Anda juga memuat naik set ujian, supaya Rimay memetakannya dengan pemetaan yang sama yang dipadankan pada set latihan.
x_train.to_csv("x_train.csv", index=False)
y_train.to_csv("y_train.csv", index=False)
x_test.to_csv("x_test.csv", index=False)

for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
Langkah 2: Optimumkan masalah untuk pelaksanaan pada perkakasan kuantum
Rimay membina dan men-transpile litar untuk pemproses yang anda pilih, jadi tiada litar yang perlu dioptimumkan secara manual. Nyatakan bilangan shot bagi setiap litar, dalam kekangan berikut:
-
Setiap ciri memerlukan satu qubit, jadi pemproses mesti mempunyai sekurang-kurangnya sebanyak qubit seperti bilangan ciri dalam set data.
-
Rimay menjalankan satu litar bagi setiap baris, baris latihan dan ujian bersama-sama. Satu job boleh meminta paling banyak 10 juta pelaksanaan, jadi bilangan baris darab
shotsmesti kekal dalam bajet tersebut.
Semak kedua-dua had sebelum anda menghantar job.
Sesuatu job juga mesti selesai dalam masa 24 jam, termasuk masa litarnya menunggu dalam baris gilir, jika tidak ia dihentikan tanpa hasil.
shots = 5000

n_rows = len(x_train) + len(x_test)
n_features = x_train.shape[1]
print(f"Qubits needed: {n_features} of {backend.num_qubits} available")
print(f"Executions: {n_rows * shots:,} of 10,000,000 allowed")
Qubits needed: 48 of 156 available
Executions: 5,000,000 of 10,000,000 allowed
Kira saiz fungsi
Setiap job dijalankan pada saiz fungsi, S, M, atau L, yang memilih sumber pengkomputeran yang digunakannya. Bagi Rimay, saiz bergantung pada bilangan baris yang dipetakan oleh sesuatu job, baris latihan dan ujian bersama-sama. Jika anda meminta saiz yang terlalu kecil, job gagal dengan ralat 4600. Untuk saiz dan had masing-masing, lihat Function sizes dalam panduan Rimay.
Sel berikut mentakrifkan pengira saiz. Ia berjalan pada mesin anda, hanya membaca data yang anda berikan kepadanya, dan tidak menghantar apa-apa.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Hantar set data mengikut susunan yang sama seperti fail dalam input_file, bersama-sama dengan mod larian:
size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Langkah 3: Laksanakan menggunakan primitif Qiskit
Jalankan Rimay dalam mod fit-transform. Ia memadankan pemetaan ciri kuantum pada x_train.csv dan y_train.csv, dan memetakan kedua-dua set latihan dan ujian dengannya. Susunan fail dalam input_file adalah penting. Senaraikan ciri latihan, label latihan, dan kemudian ciri ujian pilihan. Hantar saiz yang anda kira sebagai function_size.
job = rimay.run(
    mode="fit-transform",
    input_file=[
        "x_train.csv",
        "y_train.csv",
        "x_test.csv",
    ],  # This order matters
    backend_name=backend.name,
    shots=shots,
    function_size=size,
)
print(job.job_id)
de5094df-bb17-4924-9605-d6196a4aa999
Pantau job
Semak status job semasa ia berjalan. job.result() menyekat sehingga job selesai.
print(job.status())
INITIALIZING
result = job.result()
print(result["output_files"])
['de5094df-bb17-4924-9605-d6196a4aa999_xq_train.csv', 'de5094df-bb17-4924-9605-d6196a4aa999_xq_test.csv']
Hasilnya mengandungi mapping_id, yang mengenal pasti pemetaan yang dipadankan oleh larian ini. Anda tidak memerlukannya dalam tutorial ini, kerana set ujian telah dipetakan dalam larian yang sama. Rekodkan ID ini jika anda ingin memetakan baris baharu kemudian dengan mode="transform". Ini satu-satunya cara untuk mengakses pemetaan yang telah dipadankan, dan tanpanya, anda perlu memadankan dan membayar untuk pemetaan baharu. Pemetaan dibina untuk susun atur qubit pemproses ini, jadi larian transform kemudian mesti menghantar backend_name yang sama.
mapping_id = result["mapping_id"]
Langkah 4: Pasca-proses dan pulangkan hasil dalam format klasik yang dikehendaki
Muat turun ciri yang diubah secara kuantum
Muat turun fail yang ditulis oleh job, dengan menggunakan nama dalam output_files. Setiap nama bermula dengan ID job, jadi fail bagi larian ini kekal tersedia selepas larian seterusnya. Hantar target_name supaya setiap fail disimpan di bawah namanya sendiri.
train_file, test_file = result["output_files"]
for file_name in (train_file, test_file):
    catalog.file_download(file_name, rimay, target_name=file_name)

xq_train = pd.read_csv(train_file).to_numpy()
xq_test = pd.read_csv(test_file).to_numpy()
print(f"Quantum-transformed features: {xq_train.shape[1]}")
586kiB [00:00, 1.13MiB/s]
147kiB [00:00, 336kiB/s]
Quantum-transformed features: 99
Latih pada ciri yang diubah secara kuantum
Latih random forest pada ciri yang diubah secara kuantum sahaja.
quantum = train_random_forest(
    xq_train, y_train, n_estimators=900, max_depth=15
)
results["Quantum"] = evaluate(quantum, xq_test, y_test)
Latih pada ciri klasik dan kuantum yang digabungkan
Susun ciri asal dan ciri yang diubah secara kuantum, dan latih model yang sama pada gabungan tersebut.
xh_train = np.hstack([x_train.to_numpy(), xq_train])
xh_test = np.hstack([x_test.to_numpy(), xq_test])

hybrid = train_random_forest(
    xh_train, y_train, n_estimators=900, max_depth=15
)
results["Hybrid"] = evaluate(hybrid, xh_test, y_test)
Bandingkan hasil
Bandingkan ketiga-tiga model pada set ujian.
comparison = pd.DataFrame(results).T
print(comparison.round(3))

comparison[["Accuracy", "AUC", "F1 score"]].T.plot.bar(rot=0, figsize=(8, 4))
plt.ylim(0.5, 1.0)
plt.ylabel("Score on the test set")
plt.title("Random forest on classical, quantum, and hybrid features")
plt.show()
Accuracy    AUC  F1 score  Precision  Recall
Classical     0.765  0.781     0.846      0.782   0.921
Quantum       0.730  0.784     0.827      0.750   0.921
Hybrid        0.730  0.791     0.825      0.756   0.907

AUC mengukur sejauh mana baik sesebuah model meletakkan kredit baik di atas kredit buruk, tanpa bergantung pada ambang keputusan, yang menjadikannya metrik paling bermaklumat pada set data tidak seimbang ini (70% kredit baik). Dalam penanda aras Kipu Quantum, ciri yang diubah secara kuantum sahaja mencapai AUC yang serupa dengan garis dasar klasik, dan model hibrid, yang menggabungkan kedua-duanya, mencapai AUC dan skor F1 tertinggi. Oleh itu, ciri yang diubah secara kuantum menambah maklumat yang tidak disediakan oleh ciri klasik sahaja.
Pembersihan (pilihan)
Pemetaan yang telah dipadankan kekal tersedia sehingga anda memadamnya. Jika anda tidak mahu memetakan data lanjut dengannya, padamkannya. Pemadaman tidak melakukan kerja kuantum, tidak menggunakan masa QPU, dan tidak boleh dibuat asal.
# rimay.run(mode="delete", mapping_id=mapping_id).result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': 'eUCy4EnZM7G9jYo5b2Pu-TuCXK7zX_wPTT67g9J1dVE',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Kesimpulan
Apa yang telah anda capai
Dalam tutorial ini, anda telah mencapai perkara berikut:
-
Menyediakan set data risiko kredit dunia sebenar dengan atribut kategori dan berangka untuk pengekstrakan ciri kuantum.
-
Menetapkan garis dasar random forest klasik.
-
Menggunakan Rimay untuk memadankan pemetaan ciri kuantum pada perkakasan kuantum dan memetakan set latihan dan ujian dalam satu larian.
-
Melatih model yang sama pada ciri yang diubah secara kuantum dan pada ciri gabungan, serta membandingkannya dengan garis dasar.
Perkara utama
-
Rimay sesuai dimuatkan ke dalam saluran paip pembelajaran mesin sedia ada sebagai satu langkah prapemprosesan tambahan. Anda mengekalkan penyediaan data dan model klasik anda.
-
Bilangan qubit menghadkan bilangan ciri input, dan bilangan baris darab
shotsmenghadkan saiz sesuatu job. -
Gunakan ciri yang diubah secara kuantum yang digabungkan dengan ciri asal sebagai lalai, kerana model boleh menggunakan kedua-duanya.
Langkah seterusnya
- Baca panduan Rimay untuk mengetahui tentang semua input, memetakan data baharu dengan
mode="transform", dan melihat penanda aras lanjut. - Baca bagaimana pengekstrakan ciri kuantum diterapkan pada pengelasan imej satelit [3].
Rujukan
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.