Rimay Quantum Feature Extraction - Qiskit Function oleh Kipu Quantum
Lihat rujukan API.
Qiskit Functions ialah ciri eksperimen yang hanya tersedia kepada pengguna IBM Quantum® Premium Plan, Flex Plan dan On-Prem (melalui IBM Quantum Platform API) Plan. Ia berstatus keluaran pratonton dan tertakluk kepada perubahan.
Gambaran keseluruhan
Rimay menambah baik saluran paip pembelajaran mesin klasik dengan ciri yang dijana pada perkakasan kuantum. Fungsi ini mengambil data jadual klasik dan mengembalikan set ciri yang diubah secara kuantum. Apabila sistem kuantum memproses data, ia menjana ciri kaya yang menangkap hubungan tak linear antara input. Anda boleh menggunakan ciri yang dijana secara bersendirian, atau digabungkan dengan ciri asal anda, untuk melatih mana-mana model klasik. Pada set data bersaiz kecil dan sederhana, ciri yang diubah secara kuantum boleh meningkatkan kualiti ramalan berbanding garis dasar klasik semata-mata.
Fungsi ini dibina untuk pengguna berikut:
-
Pasukan sains data yang mempunyai saluran paip pembelajaran mesin sedia ada pada set data jadual bersaiz kecil dan sederhana, di mana kualiti ramalan telah mendatar. Anda menambah Rimay sebagai satu langkah prapemprosesan tambahan, tanpa perlu membina sebarang litar kuantum sendiri.
-
Penyelidik yang meneroka kaedah kuantum untuk tugas pembelajaran mesin.
Perihalan
Algoritma pengekstrakan ciri kuantum [1] menggabungkan dua prinsip pembelajaran mesin kuantum. Yang pertama ialah peta ciri kuantum, yang membenamkan data ke dalam ruang Hilbert berdimensi tinggi dan oleh itu menghasilkan perwakilan yang lebih ekspresif. Yang kedua ialah pengkomputeran reservoir kuantum, yang menggunakan dinamik sistem banyak jasad kuantum sebagai transformasi tak linear bagi input.
Rimay mengekod nilai ciri dan maklumat bersama antara ciri ke dalam medan setempat dan pekali gandingan Hamiltonian kaca spin. Dinamik kuantum counterdiabatic mengembangkan sistem ke arah keadaan bertenaga rendahnya, yang mengandungi campuran tak linear bagi korelasi dalam data input. Rimay mengekstrak korelasi ini dengan mengukur nilai jangkaan satu jasad dan dua jasad. Nilai jangkaan ini ialah ciri yang diubah secara kuantum yang anda masukkan ke dalam model pembelajaran mesin anda.
Aliran kerja
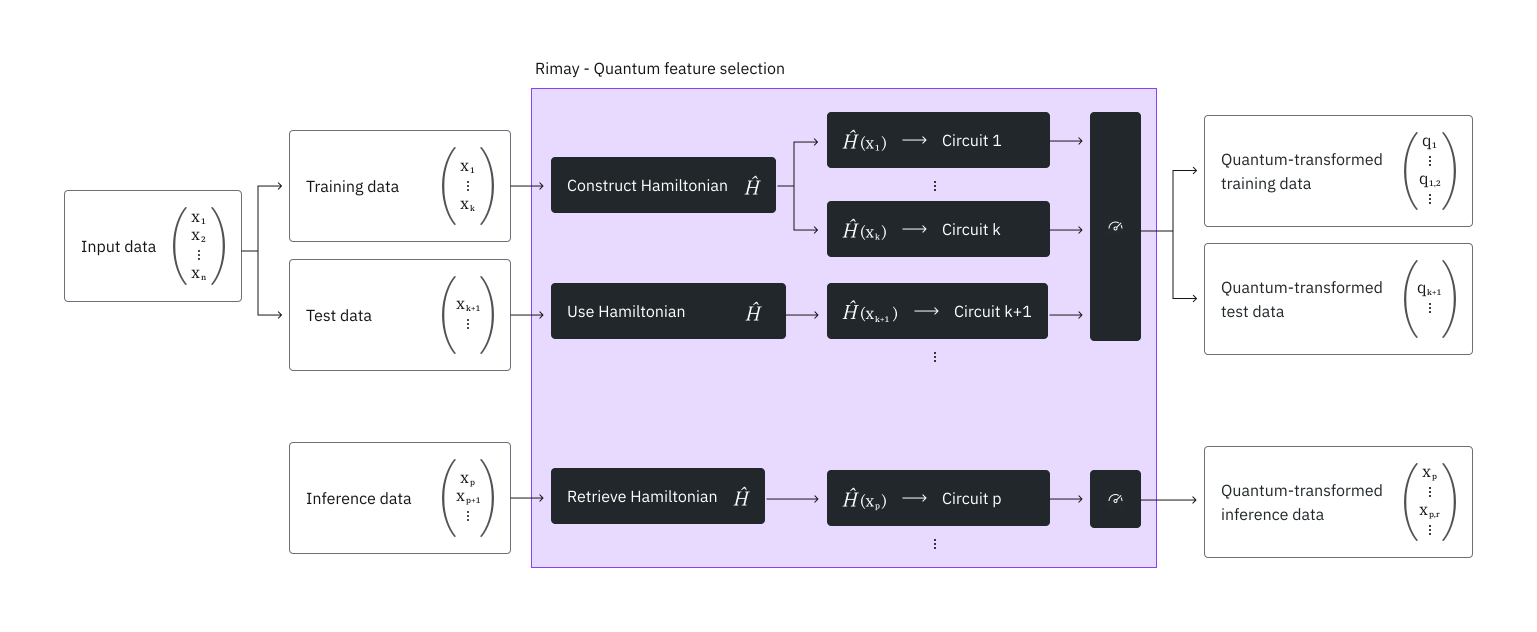
-
Praproses data jadual anda seperti yang anda lakukan untuk pembelajaran mesin klasik. Rimay memerlukan ciri berangka, jadi tukar ciri kategori kepada ciri berangka, contohnya dengan
OneHotEncoderdaripada scikit-learn. -
Pisahkan data kepada set latihan dan set ujian, dan muat naik kedua-duanya ke fungsi, seperti yang ditunjukkan dalam bahagian Contoh.
-
Rimay menggunakan data latihan untuk membina Hamiltonian yang mewakili data. Setiap ciri sepadan dengan satu qubit, dan keseluruhan set latihan menentukan ciri mana, dan oleh itu qubit mana, yang berinteraksi. Rimay menyimpan struktur ini supaya ia memetakan data ujian dan data inferens kemudian dengan Hamiltonian yang sama.
-
Bagi setiap sampel, nilai ciri menetapkan medan setempat Hamiltonian, dan maklumat bersama antara ciri menetapkan pekali gandingan struktur daripada langkah 3. Rimay mendigitalkan evolusi counterdiabatic Hamiltonian ini menjadi litar, dan menjalankan litar tersebut pada QPU.
-
Rimay mengukur rentetan bit yang terhasil, kemudian mengira nilai jangkaan satu jasad dan nilai jangkaan dua jasad bagi qubit yang digandingkan secara fizikal.
-
Anda memuat turun nilai jangkaan dalam bentuk yang boleh anda masukkan terus ke dalam model anda, atau gabungkan dengan ciri asal anda.
Kerana struktur ini, bilangan qubit yang diperlukan oleh satu larian sama dengan bilangan ciri, dan bilangan litar yang dihantarnya sama dengan bilangan sampel.
Selepas anda memadankan pemetaan, anda boleh memetakan data baharu melaluinya, contohnya untuk inferens. Rimay kemudian mendapatkan semula Hamiltonian yang dicipta semasa pemadanan dan membina litar untuk sampel baharu daripadanya.
Integrasikan Rimay ke dalam saluran paip pembelajaran mesin anda
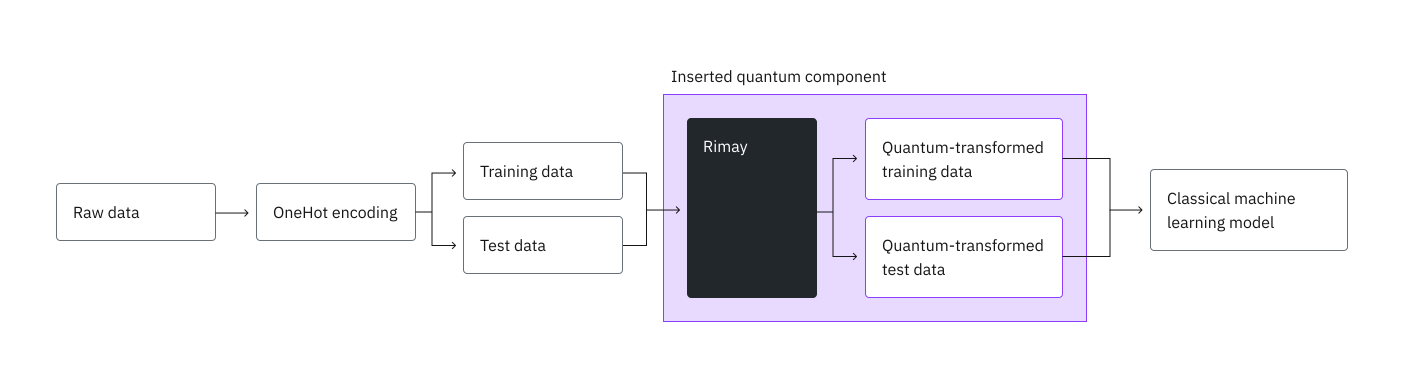
Seperti dalam saluran paip klasik, anda bermula dengan praproses data mentah, contohnya dengan pengekodan one-hot bagi ciri kategori, dan membahagikannya kepada set latihan dan set ujian. Daripada memasukkan kedua-dua set terus ke dalam model anda, anda memasukkannya ke dalam Rimay dahulu, dan melatih model anda pada ciri yang diubah secara kuantum.
Penanda aras
Kipu Quantum menanda aras Rimay pada set data kredit Jerman daripada OpenML [2], yang mengelaskan 1000 pemohon kredit sebagai risiko kredit baik atau buruk. Ia mempunyai 13 atribut kategori dan tujuh atribut berangka. Pengekodan one-hot bagi atribut kategori menghasilkan 48 ciri berangka. Penanda aras ini mengetepikan 20% sampel sebagai set ujian.
Sebagai garis dasar, beberapa model klasik dilatih pada ciri klasik. Dengan Rimay, hutan rawak dilatih dalam dua cara: pada ciri yang diubah secara kuantum sahaja (Random forest Q), dan pada ciri yang diubah secara kuantum digabungkan dengan ciri klasik (Random forest H, untuk hibrid). Jadual hanya melaporkan hutan rawak, kerana ia berprestasi terbaik pada ciri yang diubah secara kuantum.
| Model | Ciri | Ketepatan | AUC | Skor F1 | Kepersisan | Dapatan semula |
|---|---|---|---|---|---|---|
| CatBoost | Klasik | 0.775 | 0.781 | 0.850 | 0.795 | 0.914 |
| Random forest | Klasik | 0.765 | 0.781 | 0.846 | 0.782 | 0.921 |
| XGBoost | Klasik | 0.760 | 0.758 | 0.835 | 0.803 | 0.871 |
| LightGBM | Klasik | 0.770 | 0.751 | 0.840 | 0.818 | 0.864 |
| Random forest Q | Kuantum | 0.750 | 0.793 | 0.840 | 0.762 | 0.936 |
| Random forest H | Hibrid | 0.770 | 0.798 | 0.854 | 0.770 | 0.957 |
Ciri hibrid meningkatkan semua metrik hutan rawak kecuali kepersisan, dan hutan rawak hibrid mencapai AUC, skor F1 dan dapatan semula yang lebih tinggi daripada CatBoost pada ciri klasik. Kesan terbesar ialah pada dapatan semula, yang meningkat daripada 0.921 kepada 0.957. Ciri yang diubah secara kuantum sahaja tidak mencapai kepersisan model klasik.
Set ujian hanya mengandungi 200 sampel, jadi meramal satu lagi sampel dengan betul mengubah ketepatan sebanyak 0.005. Baca perbezaan ini sebagai trend yang memerlukan pengesahan lanjut, bukan sebagai kesan yang signifikan. Ketepatan ramalan juga boleh bergantung pada hingar akibat perkakasan bagi ciri yang diekstrak. Oleh itu, gunakan bilangan shot yang mencukupi supaya hingar shot tidak menghadkan hasil.
Penanda aras menggunakan sumber berikut:
| Contoh | Bilangan qubit | Bilangan sampel | Bilangan shot | Jumlah masa (min) | Penggunaan QPU (min) | Pemproses |
|---|---|---|---|---|---|---|
| German credit | 48 | 1000 | 5000 | 23 | 22 | ibm_boston |
| German credit | 48 | 1000 | 5000 | 3 | 2 | ibm_phoenix |
Bilangan sampel, iaitu bilangan litar, menentukan masa QPU. Gunakan jenis pemproses Nighthawk r2, kerana ia sangat mengurangkan masa QPU yang diperlukan.
Input
mode menentukan parameter yang diperlukan oleh satu larian. Untuk penerangan setiap parameter input, lihat rujukan API.
Fail input
-
Muat naik setiap fail dengan
catalog.file_upload()sebelum anda menjalankan fungsi. -
Muat naik menggantikan sebarang fail terdahulu dengan nama yang sama, walaupun untuk tugas yang telah anda serahkan tetapi belum bermula. Untuk menjalankan beberapa tugas pada masa yang sama, berikan fail bagi setiap tugas nama tersendiri, contohnya
run1_x_train.csvdanrun2_x_train.csv. -
Setiap fail ialah fail CSV dengan baris pengepala. Setiap lajur fail ciri ialah satu ciri, dan setiap nilai mestilah berangka.
-
y_trainmengandungi tepat satu lajur berangka, dengan satu label bagi setiap barisx_train. Petakan label kategori kepada nombor, contohnya baik dan buruk kepada 1 dan 0. -
x_testdanx_inferencemestilah mempunyai lajur yang sama denganx_train, dalam susunan yang sama.
mapping_id ialah satu-satunya cara untuk mencapai pemetaan yang dihasilkan oleh pemadanan anda, dan ia tidak boleh dicari atau dipulihkan. Ia memberi kebenaran untuk menggunakan pemetaan itu, jadi layannya seperti bukti kelayakan dan jangan kongsikannya. Jika anda kehilangannya, anda mesti memadankan pemetaan baharu, yang memerlukan satu lagi larian pada perkakasan kuantum. Rekodkan juga backend_name bagi pemadanan itu, kerana pemetaan hanya berjalan pada pemproses tersebut.
Had
-
Setiap ciri dipetakan kepada satu qubit, jadi pemproses mestilah mempunyai sekurang-kurangnya sebanyak qubit seperti bilangan ciri dalam data anda. Jika anda mempunyai lebih banyak ciri daripada itu, kurangkannya dahulu dengan teknik pemilihan ciri.
-
Setiap sampel menjadi satu litar, dan satu larian mengira sampel latihan dan ujian bersama-sama. Satu larian boleh mengandungi paling banyak 15,000 sampel.
-
Satu tugas boleh meminta paling banyak 10 juta pelaksanaan, jadi bilangan sampel darab
shotstidak boleh melebihi 10 juta. -
Satu tugas mesti selesai dalam masa 24 jam, termasuk masa litarnya menunggu dalam baris gilir pemproses. Tugas yang berjalan lebih lama dihentikan tanpa hasil. Pada pemproses yang sibuk, pastikan set data besar jauh di bawah had ini.
Output
job.result() mengembalikan kamus. Ciri yang diubah secara kuantum itu sendiri ditulis ke dalam fail CSV yang anda muat turun dengan catalog.file_download(). Untuk penerangan setiap kunci kamus, lihat rujukan API. Untuk masa yang diambil oleh setiap fasa pelaksanaan, lihat Metadata larian.
Setiap fail output mengandungi satu baris bagi setiap baris input, mengikut susunan fail input, dan satu lajur bagi setiap ciri yang diubah secara kuantum. Lajur yang namanya bermula dengan corr_ ialah nilai jangkaan dua jasad. Fail tidak mengandungi lajur label. Label data latihan anda kekal dalam fail y_train anda.
Metadata larian
resource_usage mengandungi satu entri bagi setiap fasa pelaksanaan yang dilalui larian: "RUNNING: MAPPING", "RUNNING: POST_PROCESSING", dan, pada QPU, biasanya "RUNNING: WAITING_FOR_QPU". Setiap entri mengandungi CPU_TIME, masa jam dinding bagi fasa itu dalam saat, dan QPU_TIME, masa QPU dalam saat. Pada QPU, masa QPU yang dibilkan oleh IBM direkodkan di bawah "RUNNING: MAPPING", iaitu fasa di mana litar dijalankan.
"RUNNING: WAITING_FOR_QPU" ialah masa tugas anda menunggu dalam baris gilir IBM. Larian mengambil masa ini daripada cap masa tugas IBM, dan tidak mengiranya dalam "RUNNING: MAPPING". Jika IBM tidak melaporkan cap masa tersebut bagi setiap tugas, entri itu tidak wujud, dan masa menunggu menjadi sebahagian daripada "RUNNING: MAPPING".
IBM® menyelesaikan pengiraan penggunaannya beberapa ketika selepas tugas selesai. Larian menunggu sehingga kira-kira seminit untuknya. Penggunaan yang masih dikira selepas masa itu tidak disertakan dalam QPU_TIME, dan penggunaan akhir dipaparkan di IBM Quantum Platform. Jika larian tidak dapat membaca penggunaan daripada IBM, QPU_TIME ialah None.
Contohnya:
"metadata": {
    "version": "0.3.0",
    "resource_usage": {
        "RUNNING: MAPPING": {"CPU_TIME": 12.4, "QPU_TIME": 6.0},
        "RUNNING: WAITING_FOR_QPU": {"CPU_TIME": 28.8, "QPU_TIME": 0.0},
        "RUNNING: POST_PROCESSING": {"CPU_TIME": 0.3, "QPU_TIME": 0.0},
    },
}
Bermula
Sahkan diri menggunakan kunci API IBM Quantum Platform anda, dan pilih Qiskit Function seperti berikut:
Kod berikut menganggap anda telah menyimpan bukti kelayakan anda. Jika belum, ikut arahan dalam Pasang klien Qiskit Functions Catalog untuk menyimpan akaun anda dengan kunci API anda.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(kipu-quantum/rimay)]
# Access function
rimay = catalog.load("kipu-quantum/rimay")
Saiz fungsi
Setiap tugas berjalan pada satu saiz — S, M, atau L. Jika saiz yang ditentukan terlalu kecil, tugas ditolak. Jika saiz lebih besar daripada yang diperlukan, tugas berjalan pada profil pengiraan yang lebih besar daripada yang diperlukan oleh kerja itu.
Saiz tugas Rimay bergantung pada bilangan sampel yang dipetakannya: baris x_train dan x_test untuk fit-transform, dan baris x_inference untuk transform. Label dalam y_train tidak dikira, dan larian delete tidak memetakan sebarang sampel.
| Saiz | Sampel setiap tugas | Profil pengiraan | vCPU | RAM |
|---|---|---|---|---|
S | Sehingga 2,999 | 8x32 | 8 | 32 GB |
M | 3,000 hingga 9,999 | 8x32 | 8 | 32 GB |
L | 10,000 hingga 15,000 | 16x128 | 16 | 128 GB |
Bilangan sampel ialah satu-satunya kriteria. Saiz tidak mengubah apa-apa selain profil pengiraan: had bagi ciri, sampel dan shot adalah sama untuk setiap saiz. S dan M berjalan pada profil pengiraan yang sama dan berbeza pada bilangan sampel yang dilindungi oleh setiap satu.
Lalai ialah M, digunakan apabila tugas tidak meminta saiz. Oleh itu, tugas dengan lebih daripada 9,999 sampel mesti meminta L.
Anda juga boleh membaca pemetaan itu daripada fungsi itu sendiri dengan rimay.sizes_map, dan saiz yang digunakan oleh tugas apabila ia tidak meminta satu saiz dengan rimay.default_size.
Kira saiz sebelum menyerahkan
Jalankan ini pada input anda sendiri. Ia membacanya dan tidak melakukan apa-apa lagi: tiada tugas diserahkan dan tiada apa yang ditempah, jadi anda boleh memanggilnya sebanyak yang anda suka.
Hantar set data itu sendiri, bukan nama failnya, dalam susunan yang sama dengan input_file, bersama mode larian. Langkah 2 contoh menunjukkan panggilan tersebut.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Jika saiz terlalu kecil, tugas gagal dengan ralat 4600 dan mesej itu menamakan saiz yang perlu digunakan. Jika ia lebih besar daripada yang diperlukan, tugas berjalan seperti biasa dan merekodkan peristiwa nasihat 4601.
Contoh
Contoh ini menunjukkan cara memuat naik data, menjalankan fungsi, dan mendapatkan semula ciri yang diubah secara kuantum. Untuk contoh hujung ke hujung yang merangkumi praproses dan latihan model klasik, lihat tutorial.
1. Muat naik data
Contoh ini menggunakan set data sintetik kecil dengan empat ciri berangka dan satu label binari, supaya satu larian hanya memerlukan empat qubit dan selesai dengan cepat. Sel seterusnya menulisnya ke empat fail CSV: ciri latihan, label latihan, ciri ujian, dan ciri untuk langkah 4 contoh ini. Untuk menggunakan data anda sendiri, tulis set latihan dan ujian anda yang telah diproses ke dalam fail dengan susun atur yang sama.
from pathlib import Path

Path("x_train.csv").write_text("""f0,f1,f2,f3
0.7227,1.3355,1.9595,2.5562
0.2731,0.5779,0.8983,1.1624
0.1139,0.1817,0.2163,0.2426
0.0341,0.1311,0.0854,0.09
0.8996,1.6951,2.497,3.3407
0.9669,1.8906,2.7705,3.6569
0.6366,1.2821,1.8793,2.4602
0.7718,1.4979,2.2223,2.933
0.5465,1.1008,1.67,2.2195
0.9475,1.9423,2.8942,3.8199
0.8829,1.6842,2.4703,3.2865
0.0675,0.0365,0.0705,0.0162
""")
Path("y_train.csv").write_text("label\n1\n0\n0\n0\n1\n1\n0\n1\n0\n1\n1\n0\n")
Path("x_test.csv").write_text("""f0,f1,f2,f3
0.543,1.0786,1.5684,2.0607
0.9928,1.9037,2.9302,3.8422
0.2269,0.3637,0.4628,0.597
0.9896,1.9511,2.8913,3.8208
""")
Path("x_inference.csv").write_text("""f0,f1,f2,f3
0.2708,0.542,0.8506,1.0897
0.3585,0.6025,0.9517,1.2609
0.8871,1.6559,2.4577,3.2992
""")
95
Muat naik fail latihan dan ujian. Anda memuat naik x_inference.csv dalam langkah 4.
for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
2. Jalankan fungsi
Kira saiz larian daripada data yang anda muat naik, dengan kalkulator daripada Saiz fungsi.
import pandas as pd

x_train = pd.read_csv("x_train.csv")
y_train = pd.read_csv("y_train.csv")
x_test = pd.read_csv("x_test.csv")

size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Pilih pemproses dengan sekurang-kurangnya sebanyak qubit seperti bilangan ciri dalam data anda, dan jalankan fungsi dalam mod fit-transform dengan saiz itu. Data sampel mempunyai empat ciri, jadi mana-mana pemproses IBM Quantum boleh menjalankannya.
backend = catalog.least_busy(operational=True, simulator=False)

job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv", "x_test.csv"],
    backend_name=backend.name,
    shots=5000,
    function_size=size,
)
print(job.job_id)
85dabc9f-a769-4f4a-8e92-f3be73f85ca2
Semak status beban kerja atau kembalikan hasil seperti berikut:
# Monitor the job status
job.status()
'DONE'
result = job.result()

# Keep both: the mapping_id is the only handle on the mapping this run
# fitted, and the mapping runs only on the processor it was fitted on.
mapping_id = result["mapping_id"]
fit_backend_name = result["backend_name"]
3. Dapatkan semula hasil
Muat turun ciri yang diubah secara kuantum. Hantar target_name supaya setiap fail disimpan di bawah namanya sendiri.
for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
693iB [00:00, 171kiB/s]
254iB [00:00, 111kiB/s]
4. Petakan data baharu
Selepas anda melatih model anda, petakan data baharu dengan pemetaan yang telah dipadankan, contohnya untuk menjalankan inferens. Contoh ini memetakan x_inference.csv, yang ditulis oleh sel pertama contoh ini. Hantar mapping_id yang dikembalikan oleh pemadanan, supaya baris baharu dipetakan dengan pemetaan yang sama dan bukan yang baharu.
Pemetaan dibina untuk susun atur qubit satu pemproses, jadi hantar backend_name yang sama dengan pemadanan, yang dikembalikan oleh pemadanan dalam result["backend_name"]. Jangan gunakan least_busy() untuk memilih pemproses, kerana ia mungkin mengembalikan yang lain. Rimay menolak mana-mana pemproses lain sebelum ia menyerahkan apa-apa. Bilangan shot juga datang daripada pemadanan.
catalog.file_upload("x_inference.csv", rimay)

x_inference = pd.read_csv("x_inference.csv")
size = calculate_function_size([x_inference], mode="transform")

job = rimay.run(
    mode="transform",
    input_file=["x_inference.csv"],
    # The processor the mapping was fitted on
    backend_name=fit_backend_name,
    shots=5000,
    mapping_id=mapping_id,
    function_size=size,
)
# Monitor the job status
job.status()
'DONE'
result = job.result()

for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
202iB [00:00, 73.5kiB/s]
5. Padam pemetaan
Apabila anda tidak lagi memerlukan pemetaan yang telah dipadankan, padamkannya. Larian delete tidak melakukan kerja kuantum, jadi ia tidak memerlukan pemproses, shot, atau saiz fungsi. Anda tidak boleh membuat asal pemadaman. Selepas pemadaman, mapping_id tidak lagi merujuk kepada apa-apa, dan larian transform dengannya gagal.
job = rimay.run(mode="delete", mapping_id=mapping_id)
job.result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': '30L40joyUPYfnvgwo2d7MXXSzqvHkggR-Kzn81wfIYw',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Dapatkan mesej ralat
Jika status beban kerja anda ialah ERROR, gunakan job.error_message() untuk mendapatkan mesej ralat, seperti berikut:
job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv"],
    backend_name=backend.name,
    shots=0,
)
job.error_message()
Setiap ralat yang dilaporkan oleh Rimay membawa kod daripada kod ralat IBM Quantum, satu mesej, dan satu penyelesaian yang menamakan nilai yang anda hantar dan nilai yang dibenarkan. Jadual berikut menyenaraikan ralat yang paling lazim:
| Kod | Punca |
|---|---|
1221 | Parameter tiada atau mempunyai jenis yang salah, mode tidak sah, fail yang dinamakan dalam input_file tidak dimuat naik, fail tidak sepadan antara satu sama lain, ciri bukan berangka, atau mapping_id tidak sepadan dengan pemetaan yang disimpan. |
1221 | Larian "transform" menamakan backend_name yang berbeza daripada pemadanan yang menghasilkan pemetaannya. |
1216 | Instans anda tidak mempunyai pemproses dengan backend_name yang anda hantar. Penyelesaian menyenaraikan pemproses yang dimilikinya. |
1200 | Kunci API anda tidak mempunyai akses kepada instans di bawah mana tugas berjalan. |
3200 | backend_name tidak bermula dengan ibm_. |
4500 | Data mempunyai lebih banyak ciri daripada bilangan qubit pemproses. |
6000 | Bilangan sampel darab shots melebihi 10 juta pelaksanaan. |
6001 | shots lebih kecil daripada 1. |
6002 | Data mempunyai lebih banyak sampel daripada yang dibenarkan oleh satu larian. |
Kes penggunaan
Dalam pengelasan berjadual pada set data bersaiz kecil dan sederhana, Kipu Quantum telah menggunakan pengekstrakan ciri kuantum untuk perkara berikut:
Selain data berjadual, rangkaian neural beku boleh mengubah imej kepada ciri berangka, yang kemudian dipetakan oleh pengekstrakan ciri kuantum kepada ciri yang diubah secara kuantum:
Dapatkan sokongan
Untuk sokongan, hubungi support@kipu-quantum.com.
Langkah seterusnya
-
Lawati rujukan API untuk Qiskit Function ini.
-
Cuba tutorial Kelaskan risiko kredit dengan pengekstrakan ciri kuantum Rimay Kipu Quantum.
Rujukan
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
Maklumat tambahan
Rimay ialah perkataan Quechua yang bermaksud "menerangkan".