Pengesanan ralat overhed-rendah dengan kod ruang-masa
Anggaran penggunaan: 4 minit pada pemproses Heron (ibm_kingston atau setara) (NOTA: Ini hanyalah anggaran. Masa jalan anda mungkin berbeza.)
Hasil pembelajaran
-
Bagaimana pemeriksaan Pauli ruang-masa mengesan ralat logik dalam litar Clifford, dan bagaimana pemilihan-pasca berdasarkan sindrom mereka meningkatkan fideliti taburan yang disampel.
-
Cara menggunakan pakej
qiskit-pauliceuntuk mencari dan memasukkan pemeriksaan yang cekap-perkakasan secara automatik denganget_check_qubits,NoiseModel, danadd_pauli_checks. -
Cara menganggarkan fideliti keadaan penstabil dengan menyampel penstabilnya dan pemilihan-pasca berdasarkan sindrom pemeriksaan.
-
Cara menjalankan aliran kerja pengesanan-ralat penuh pada perkakasan IBM Quantum® dan membandingkan fideliti berhingar dan pemilihan-pasca.
Prasyarat
-
Asas perkakasan untuk pengkomputeran kuantum skala-utiliti.
-
Formalisme Clifford dan penstabil, termasuk bagaimana kumpulan penstabil menerangkan keadaan penstabil tulen.
Latar belakang
Pengesanan ralat overhed-rendah dengan kod ruang-masa [1] oleh Simon Martiel dan Ali Javadi-Abhari memperkenalkan kaedah untuk mengesan ralat logik dalam litar dominan-Clifford yang terletak antara pembetulan ralat penuh dan mitigasi ralat yang lebih ringan. Idea ini dibina berdasarkan pemeriksaan Pauli koheren (CPC) daripada Single-shot error mitigation by coherent Pauli checks [2] oleh van den Berg dan lain-lain. Dalam kedua-dua pendekatan, litar "payload" Clifford dikusutkan dengan qubit ancilla untuk memeriksa invarian tertentu. Mengukur ancilla menghasilkan sindrom yang melaporkan sama ada ralat dikesan semasa pelaksanaan. Mengekalkan hanya sampel tanpa ralat yang dikesan meningkatkan fideliti taburan yang disampel, dengan kos kadar pemilihan-pasca yang berkurang.
Perbezaan utama antara pemeriksaan Pauli koheren dan pemeriksaan ruang-masa ialah operator yang mereka ukur. Pemeriksaan Pauli koheren mengukur operator berbobot-tinggi yang tersetempat-masa. Pada topologi qubit dengan sambungan terhad, seperti heavy hex, pemeriksaan tersebut memerlukan banyak get SWAP dan sering menjadikan litar terlalu mendalam untuk dijalankan secara praktikal. Melaksanakan pemeriksaan sebagai kod ruang-masa sebaliknya mengagihkan setiap pemeriksaan merentasi litar payload dalam ruang dan masa. Ini menghasilkan pengekodan yang cekap-perkakasan yang kekal berkesan dalam mengesan ralat logik sambil mengekalkan overhed qubit dan kedalaman yang rendah.
Apa yang dilakukan oleh pakej qiskit-paulice
Pakej qiskit-paulice mengautomasikan pembinaan pemeriksaan ini supaya anda tidak perlu membinanya secara manual. Peranan utamanya adalah untuk mencari dan memasukkan pemeriksaan Pauli spacetime yang sah pada lokasi dalam litar yang memaksimumkan pengesanan ralat sambil meminimumkan overhead qubit. Satu pemeriksaan adalah sah apabila operatornya membiarkan tindakan logik litar payload tidak berubah, berat rendah apabila ia menggunakan sedikit get pengikat, dan berkesan apabila ia mengesan sebahagian besar ralat, berbanding dengan hingar yang diperkenalkan oleh pemeriksaan itu sendiri. Pakej ini menilai calon pemeriksaan berbanding model hingar dan mengesahkan yang terbaik ke dalam litar. Tutorial ini menggunakan tiga kaedah API:
-
get_check_qubitsmemeriksa peta gandingan backend dan mengembalikan pasangan qubit sasaran dan ancilla. Pemeriksaan padatarget_qubits[i]menggunakanancilla_qubits[i]. -
NoiseModel.from_backendmembina model hingar kasar daripada data penanda aras backend. Model ini menilai calon pemeriksaan, jadi model hingar yang tepat dan dipelajari tidak diperlukan. Untuk model Pauli-Lindblad yang dipelajari, lihatNoiseModel.from_pauli_lindblad_maps. -
add_pauli_checksmencari dan memasukkan pemeriksaan ke dalam litar. Ia mengembalikan urutan objekCheckedCircuitdengan bilangan pemeriksaan yang semakin bertambah, dan setiap objek menyediakanget_postselection_methodyang memetakan bitstring yang diukur kepada vektor sindrom. Argumencostmemilih fungsi yang menilai pemeriksaan (gamma, overhead pensampelan saluran hingar songsang pascapilih, atauLER, kadar ralat logik). Argumenmethodmemilih strategi carian (windowed,genetic, atauwindowed_genetic). Tutorial ini menggunakancost="gamma"danmethod="windowed", yang bersama-sama memberikan pemilihan pemeriksaan yang deterministik dan boleh diulang.
Anggarkan kesetiaan daripada pensampelan stabilizer
Untuk mengukur seberapa baik pengesanan ralat berfungsi, anda boleh menganggarkan kesetiaan keadaan stabilizer yang secara ideal disediakan oleh litar berbanding keadaan hingar yang sebenarnya dikeluarkan oleh perkakasan. Projektor pada keadaan stabilizer tulen bersamaan dengan purata seragam ke atas elemen kumpulan stabilizernya :
Menggantikan ini ke dalam kesetiaan memberikan kesetiaan sebagai nilai jangkaan purata bagi setiap stabilizer berkenaan dengan :
Untuk masalah yang lebih besar, menyenaraikan semua stabilizer adalah tidak praktikal, jadi anda boleh menganggarkan kesetiaan daripada sampel rawak. Mengambil stabilizer secara seragam rawak daripada memberikan anggaran tidak bias:
Kerana litar Clifford menyediakan keadaan stabilizer, anda boleh menganggarkan kesetiaannya terus daripada nilai jangkaan stabilizer yang disampel. Tutorial ini mula-mula melalui aliran kerja pada simulator dengan litar kecil, kemudian menjalankan aliran kerja yang sama pada perkakasan dengan litar yang lebih besar dan lebih dalam. Apabila litar merangkumi lebih banyak operasi bukan-Clifford, bilangan pemeriksaan sah berkurangan dengan cepat, jadi kaedah ini berfungsi paling baik untuk litar yang didominasi oleh Clifford.
Keperluan
Sebelum memulakan tutorial ini, pastikan anda telah memasang perkara berikut:
-
Qiskit SDK v2.0 atau lebih baru, dengan sokongan visualisasi
-
Qiskit Runtime v0.40 atau lebih baru (
pip install qiskit-ibm-runtime) -
Qiskit Aer v0.17 atau lebih baru (
pip install qiskit-aer) -
Qiskit Paulice (
pip install qiskit-paulice) -
tqdm (
pip install tqdm)
Persediaan
Import pustaka yang diperlukan dan takrifkan fungsi pembantu yang tidak tersedia sebagai import. Fungsi random_clifford_circuit membina payload Clifford rawak brickwork, find_check_layout mencari peta gandingan backend untuk laluan qubit ralat rendah dengan banyak ancilla yang tersedia, learned_noise_model menukar output NoiseLearner kepada model hingar qiskit-paulice, append_basis_rotation memutarkan litar supaya stabilizer diukur dalam asas pengiraan, expectation mengira nilai jangkaan stabilizer daripada kiraan yang disampel, dan cum_mean_sem menjejaki anggaran kesetiaan yang berjalan.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime qiskit-paulice tqdm
# Standard library imports
import random
import time

# External libraries
import matplotlib.pyplot as plt
import numpy as np
from tqdm import tqdm

# Qiskit
from qiskit import QuantumCircuit
from qiskit.quantum_info import Clifford, Pauli, PauliLindbladMap, PauliList
from qiskit.result import sampled_expectation_value
from qiskit.transpiler import generate_preset_pass_manager
from qiskit.visualization import plot_coupling_map

# Qiskit Aer
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel as AerNoiseModel
from qiskit_aer.noise import ReadoutError, depolarizing_error

# Qiskit IBM Runtime
from qiskit_ibm_runtime import NoiseLearner, QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler

# Qiskit Paulice
from qiskit_paulice import add_pauli_checks
from qiskit_paulice.layout import get_check_qubits
from qiskit_paulice.noise_models import NoiseModel
def random_clifford_circuit(
    num_qubits: int, depth: int, rng: np.random.Generator
) -> QuantumCircuit:
    """Brickwork random Clifford on `num_qubits`, with `depth` CZ layers."""
    qc = QuantumCircuit(num_qubits)
    qc.h(range(num_qubits))
    for d in range(depth):
        for i in range(d % 2, num_qubits - 1, 2):
            qc.cz(i, i + 1)
        for q in range(num_qubits):
            if rng.integers(0, 2):
                qc.sx(q)
            if rng.integers(0, 2):
                qc.s(q)
            if rng.integers(0, 2):
                qc.sx(q)
    return qc

def find_check_layout(
    backend,
    num_qubits: int,
    rng: np.random.Generator,
    num_trials: int = 200,
    max_gate_error: float = 0.03,
    max_readout_error: float = 0.2,
) -> list[int]:
    """Find a low-error path of `num_qubits` qubits with many available ancillas.

    Builds random self-avoiding walks on the coupling map, excluding the qubits
    and two-qubit gates whose reported errors exceed the thresholds, and keeps
    the path that offers the most target and ancilla pairs. Ties are broken by
    the lower average two-qubit gate error along the path.
    """
    target = backend.target
    gate_2q = next(
        name for name in ("cz", "ecr", "cx") if name in target.operation_names
    )

    # Collect per-edge gate errors and per-qubit readout errors
    edge_error = {}
    for qubits, props in target[gate_2q].items():
        edge = tuple(sorted(qubits))
        if props is not None and props.error is not None:
            edge_error[edge] = min(edge_error.get(edge, 1.0), props.error)
    readout_error = {
        qubit: target["measure"][(qubit,)].error
        for (qubit,) in target["measure"]
    }

    # Keep only the edges whose gate and readout errors are acceptable
    adjacency = {}
    for (q1, q2), error in edge_error.items():
        if (
            error <= max_gate_error
            and readout_error.get(q1, 1.0) <= max_readout_error
            and readout_error.get(q2, 1.0) <= max_readout_error
        ):
            adjacency.setdefault(q1, set()).add(q2)
            adjacency.setdefault(q2, set()).add(q1)

    # Random self-avoiding walks; keep the path with the most check pairs
    starts = sorted(adjacency)
    best_path = None
    best_score = (-1, float("inf"))
    for _ in range(num_trials):
        path = [starts[rng.integers(len(starts))]]
        while len(path) < num_qubits:
            options = sorted(adjacency[path[-1]] - set(path))
            if not options:
                break
            path.append(options[rng.integers(len(options))])
        if len(path) < num_qubits:
            continue
        num_pairs = len(get_check_qubits(backend.coupling_map, path)[0])
        mean_error = float(
            np.mean(
                [edge_error[tuple(sorted(e))] for e in zip(path, path[1:])]
            )
        )
        if num_pairs > best_score[0] or (
            num_pairs == best_score[0] and mean_error < best_score[1]
        ):
            best_path, best_score = path, (num_pairs, mean_error)

    if best_path is None:
        raise RuntimeError(
            "No connected low-error path found. Relax the error thresholds."
        )
    return best_path

def learned_noise_model(layer_errors, layout: list[int]) -> NoiseModel:
    """Build a `NoiseModel` from `NoiseLearner` results.

    `NoiseLearner` reports one `PauliLindbladError` per entangling layer, whose
    generators are indexed against that layer's own physical qubits, while
    `NoiseModel.from_pauli_lindblad_maps` expects `PauliLindbladMap`s indexed the
    way `NoiseModel.from_backend` indexes them: by position in `layout`. This
    translates between the two and drops generators that fall outside `layout`.
    """
    phys_to_virt = {phys: virt for virt, phys in enumerate(layout)}
    maps = []
    for layer in layer_errors:
        if layer.error is None:
            continue
        terms = []
        for pauli, rate in zip(
            layer.error.generators, layer.error.rates, strict=True
        ):
            label, indices = [], []
            for local, phys in enumerate(layer.qubits):
                x, z = bool(pauli.x[local]), bool(pauli.z[local])
                if not (x or z):
                    continue
                if phys not in phys_to_virt:
                    break  # generator reaches outside the layout, so skip it
                label.append("Y" if x and z else "X" if x else "Z")
                indices.append(phys_to_virt[phys])
            else:
                if label:
                    terms.append(
                        ("".join(label), tuple(indices), float(rate))
                    )
        # Each map needs a 2-qubit generator to define an entangling layer
        if any(len(t[1]) == 2 for t in terms):
            maps.append(
                PauliLindbladMap.from_sparse_list(
                    terms, num_qubits=len(layout)
                )
            )
    if not maps:
        raise RuntimeError(
            "No usable layer errors. Check that the learner ran on this layout."
        )
    return NoiseModel.from_pauli_lindblad_maps(maps)

def append_basis_rotation(
    circuit: QuantumCircuit, pauli: Pauli
) -> QuantumCircuit:
    """Strip measurements, append basis rotations for `pauli`, and re-measure."""
    out = circuit.remove_final_measurements(inplace=False)
    for q in range(pauli.num_qubits):
        if pauli.x[q]:
            if pauli.z[q]:
                out.sdg(q)
            out.h(q)
    out.measure_all()
    return out

def expectation(counts: dict, pauli: Pauli) -> float:
    """Expectation value of `pauli` from counts measured in the Z basis.

    Pads with identity on any qubits beyond the support of `pauli`, such as the
    check ancillas that appear in the postselected counts.
    """
    if not counts:
        return float("nan")
    n = pauli.num_qubits
    sign = -1 if int(pauli.phase) % 4 == 2 else 1
    total = len(next(iter(counts)))
    label = "".join(
        "Z" if q < n and (pauli.x[q] or pauli.z[q]) else "I"
        for q in range(total - 1, -1, -1)
    )
    return sign * sampled_expectation_value(counts, label)

def cum_mean_sem(values: np.ndarray):
    """Cumulative mean and standard error of the mean, ignoring NaNs."""
    valid = ~np.isnan(values)
    total = np.cumsum(np.where(valid, values, 0.0))
    total_sq = np.cumsum(np.where(valid, values**2, 0.0))
    count = np.maximum(np.cumsum(valid).astype(float), 1)
    mean = total / count
    sem = np.sqrt(np.maximum(total_sq / count - mean**2, 0) / count)
    return np.where(np.cumsum(valid) > 0, mean, np.nan), sem
Contoh simulator berskala kecil
Bahagian ini melalui aliran kerja penuh pada simulator hingar. Ia menggunakan data penanda aras backend untuk memilih susun atur qubit dan model hingar, mencari pemeriksaan secara automatik, dan menggunakan pascapilihan pada taburan yang disampel untuk menunjukkan peningkatan kesetiaan.
Langkah 1: Petakan input klasik kepada masalah kuantum
Litar payload adalah litar Clifford rawak brickwork satu dimensi yang cetek. Kerana litar itu adalah Clifford, ia menyediakan keadaan stabilizer yang kesetiaannya boleh anda anggarkan terus daripada nilai jangkaan stabilizer yang disampel. Mulakan dengan litar cetek supaya pemeriksaan mudah divisualisasikan dalam langkah seterusnya.
num_qubits = 12
depth = 4
seed = 1764
rng = np.random.default_rng(seed)
np.random.seed(seed)

circuit = random_clifford_circuit(num_qubits, depth, rng)
circuit.measure_all()
circuit.draw("mpl", fold=-1, scale=0.6)

Langkah 2: Optimumkan untuk pelaksanaan perkakasan kuantum
Memetakan litar kepada perkakasan menetapkan susun atur qubit fizikal, model hingar yang menilai calon pemeriksaan, dan pemeriksaan itu sendiri.
Pertama, pilih backend dan cari peta gandingannya untuk susun atur qubit satu dimensi dengan pembantu find_check_layout yang ditakrifkan dalam bahagian Persediaan. Pembantu ini membina lintasan rawak mengelak-diri yang mengelakkan get dan bacaan berralat tertinggi, dan ia mengekalkan laluan yang menawarkan pasangan sasaran dan ancilla paling banyak. Kerana carian membaca data ketersambungan dan ralat daripada backend itu sendiri, kod yang sama berjalan pada mana-mana QPU IBM Quantum. Fungsi get_check_qubits kemudian mengembalikan pasangan sasaran dan ancilla, di mana pemeriksaan pada target_qubits[i] menggunakan ancilla_qubits[i].
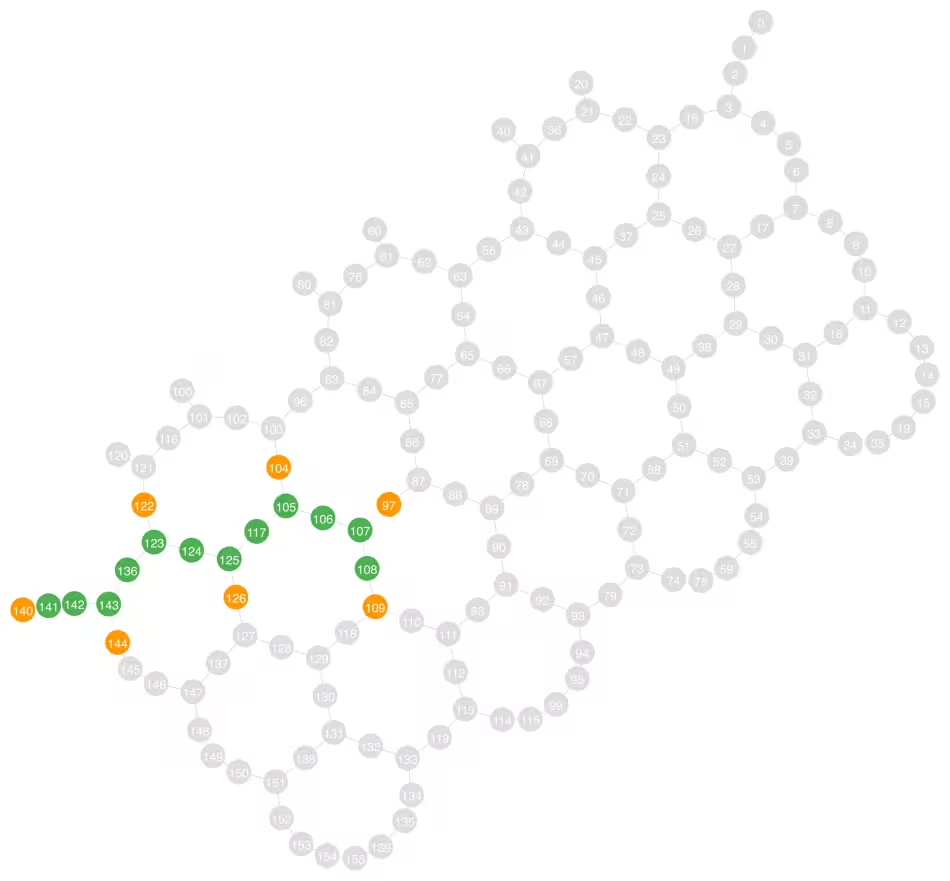
Dalam graf gandingan yang berikut, qubit hijau adalah qubit payload dan qubit oren adalah ancilla yang melaksanakan pemeriksaan. Qubit dengan ancilla bersebelahan digunakan sebagai qubit sasaran untuk pemeriksaan.
service = QiskitRuntimeService()
backend = service.least_busy(operational=True, simulator=False)

print(f"Backend: {backend.name}")

# Search for a low-error path, then pair each target qubit with a neighboring ancilla
layout = find_check_layout(backend, num_qubits, rng)
target_qubits, ancilla_qubits = get_check_qubits(backend, layout)
num_checks = len(target_qubits)

print(f"Target qubits:  {target_qubits}")
print(f"Ancilla qubits: {ancilla_qubits}")
plot_coupling_map(
    num_qubits=backend.num_qubits,
    qubit_coordinates=getattr(
        backend.configuration(), "qubit_coordinates", None
    ),
    coupling_map=backend.configuration().coupling_map,
    figsize=(12, 12),
    qubit_color=[
        "#4CAF50"
        if i in set(layout)
        else "#FF9800"
        if i in set(ancilla_qubits)
        else "#DDDDDD"
        for i in backend.coupling_map.graph.node_indices()
    ],
    qubit_size=220,
    line_width=2,
    font_size=90,
)
Backend: ibm_boston
Target qubits:  [105, 107, 108, 123, 125, 141, 143]
Ancilla qubits: [104, 97, 109, 122, 126, 140, 144]
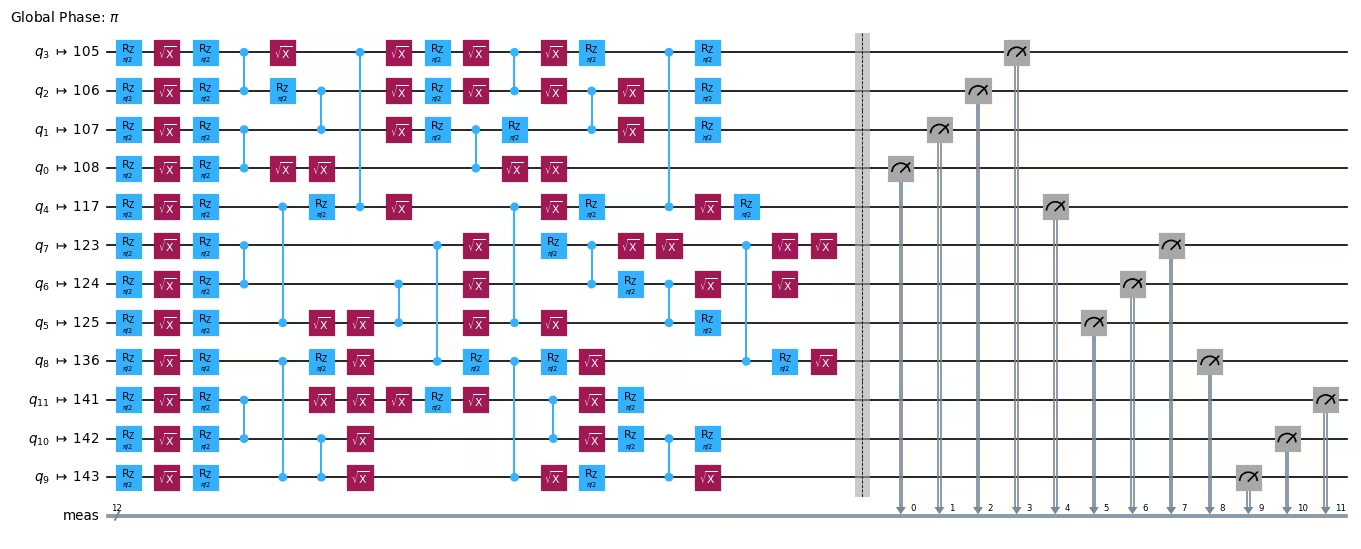
Dengan backend dan susun atur dipilih, transpile payload kepada litar seni bina set arahan (ISA). Hanya perlu menetapkan susun atur dan menterjemahkan get kepada set get asli backend.
pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=layout
)
circuit_isa = pm.run(circuit)
circuit_isa.draw("mpl", fold=-1, scale=0.6)
Seterusnya, modelkan bagaimana hingar get dan bacaan pada backend mempengaruhi pelaksanaan. Model hingar menentukan di mana dalam litar pemeriksaan menangkap ralat paling banyak. Model yang lebih tepat memperbaiki pengesanan, tetapi biasanya tidak perlu mempelajarinya dengan mensampel QPU. Model yang berikut mengekstrapolasikan saluran depolarisasi seragam untuk hingar get dan bacaan daripada data penanda aras qiskit-ibm-runtime.
noise_model = NoiseModel.from_backend(
    backend, layout, uniform_gate_noise=True
)
print(noise_model)
NoiseModel(gate_noise=0.001079865281450939, readout_noise=0.006001790364583333, idling_noise=None)
Sekarang tambahkan pemeriksaan ke dalam litar. Fungsi add_pauli_checks mengambil payload Clifford, senarai qubit sasaran, dan model hingar. Argumen ancilla_qubits memberitahu fungsi ancilla fizikal mana yang perlu dipasangkan dengan setiap sasaran. Pemeriksaan ditambah mengikut urutan qubit sasaran muncul, jadi susun atur akhir litar yang diperiksa ialah layout + ancilla_qubits. Untuk menjalankan litar output dengan pemeriksaan yang lebih sedikit (i), susun atur akhir ialah layout + ancilla_qubits[:i].
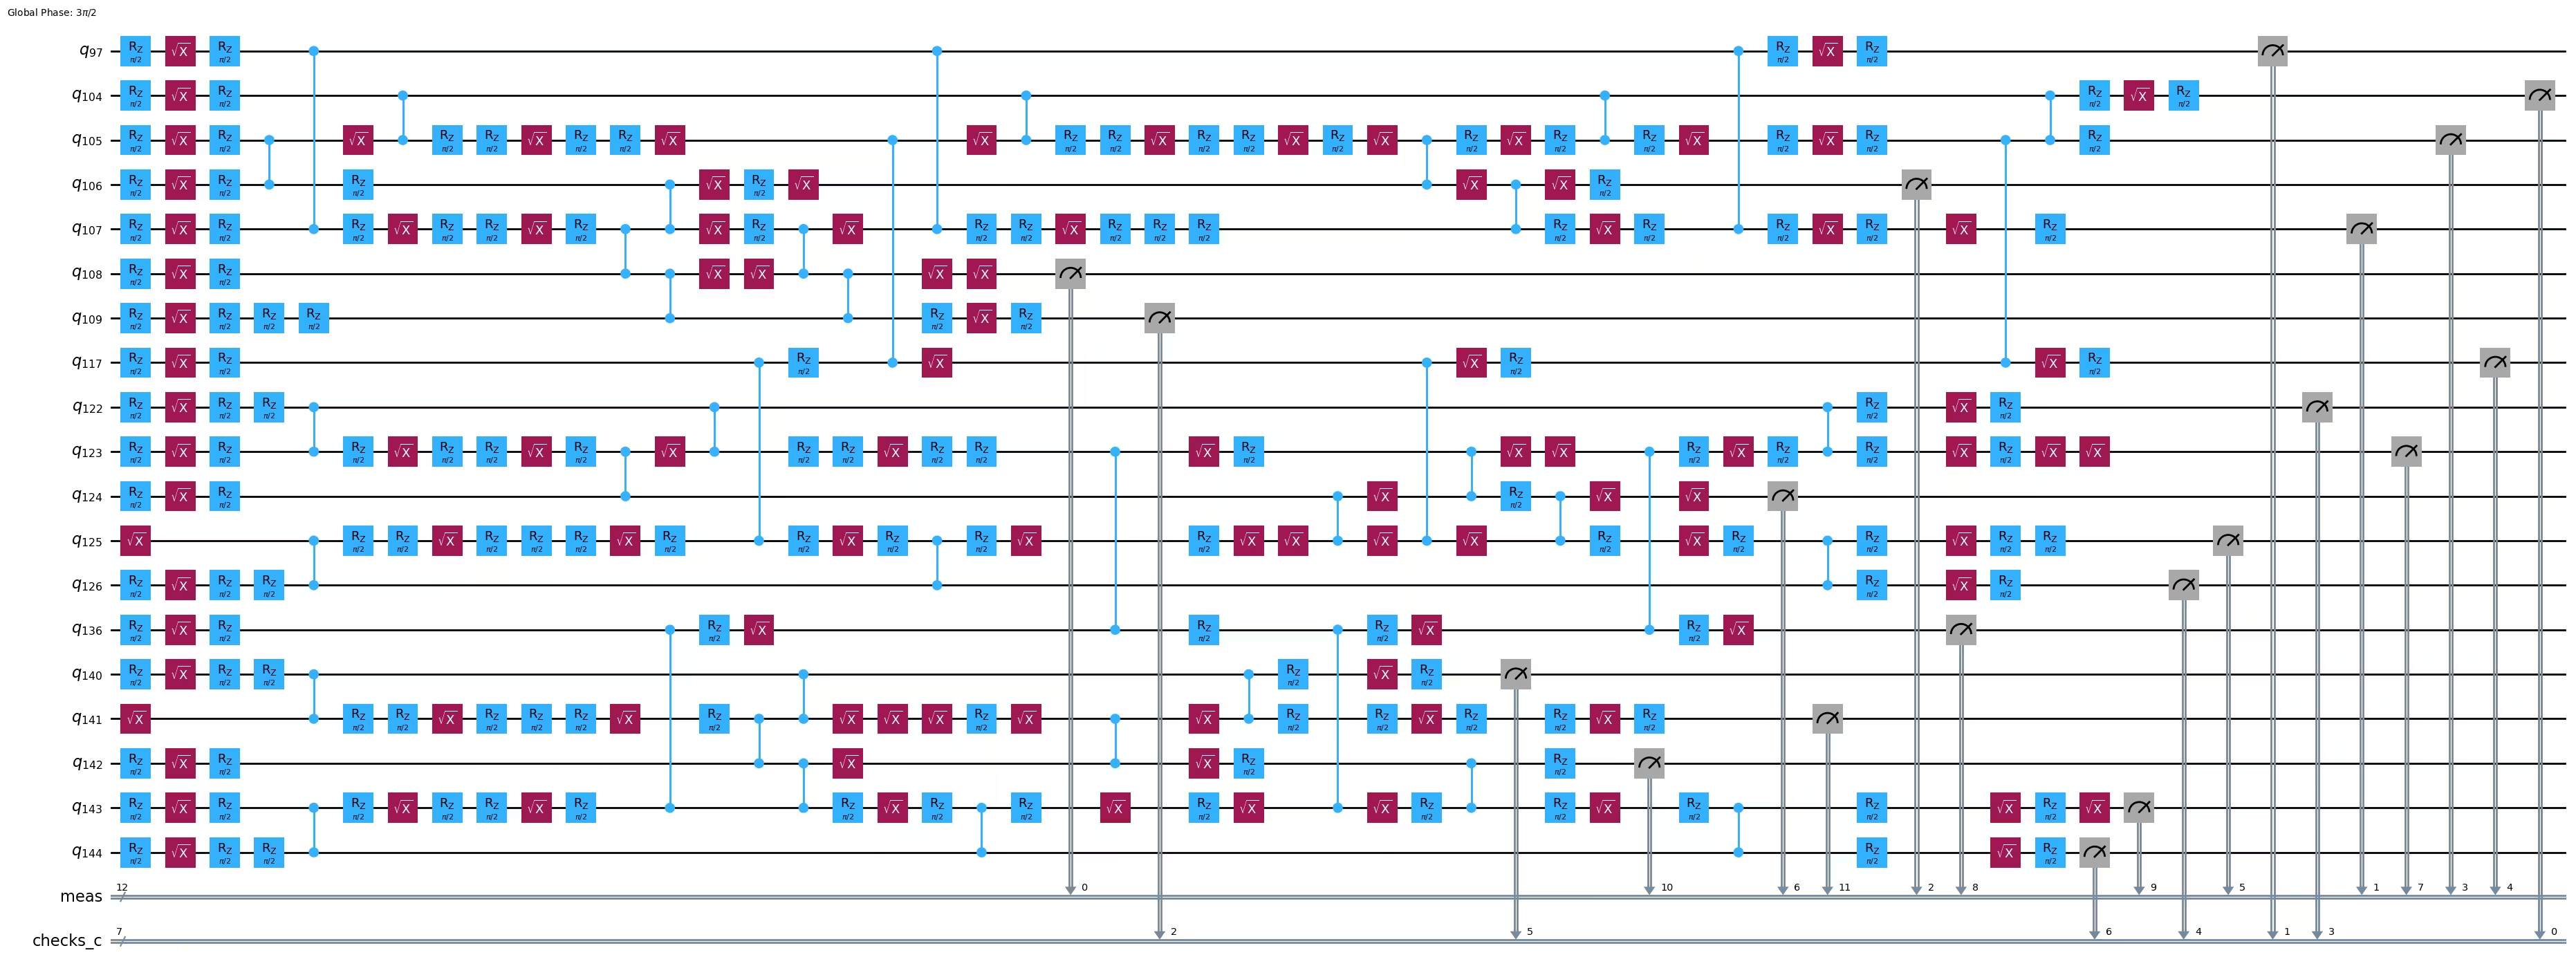
Output add_pauli_checks adalah urutan litar dengan bilangan pemeriksaan yang semakin bertambah, daripada tiada pemeriksaan sehingga satu pemeriksaan pada setiap qubit sasaran. Visualisasi mengesahkan bahawa pemeriksaan menggunakan pasangan sasaran dan ancilla yang ditentukan. Untuk perincian mengenai mencari pemeriksaan yang baik, lihat Bahagian II hingga IV maklumat tambahan dalam rujukan [1].
checked = add_pauli_checks(
    circuit_isa,
    target_qubits,
    noise_model,
    ancilla_qubits=ancilla_qubits,
    cost="gamma",
    method="windowed",
    seed=seed,
)

print(f"Physical layout of payload and ancillas: {layout + ancilla_qubits}")
print("Checked circuit:")
checked[-1].circuit.draw("mpl", fold=-1, idle_wires=False)
Physical layout of payload and ancillas: [108, 107, 106, 105, 117, 125, 124, 123, 136, 143, 142, 141, 104, 97, 109, 122, 126, 140, 144]
Checked circuit:
Langkah 3: Laksanakan menggunakan primitif Qiskit
Untuk menjadikan kesan hingar get ketara, tingkatkan kedalaman payload dan sampel subset stabilizernya. Setiap stabilizer secara umumnya tidak komut secara qubit-wise dengan yang lain, jadi satu set pemeriksaan tidak sah untuk dua stabilizer yang berbeza. Daripada mengumpulkan stabilizer ke dalam set yang komut, cari set pemeriksaan yang baik untuk setiap stabilizer secara berasingan. Mensampel stabilizer secara seragam rawak memberikan anggaran kesetiaan tidak bias.
Bina litar yang lebih dalam dan lukis sampel rawak stabilizernya.
depth = 24
num_stabilizers = 20
num_shots = 1_000

circuit = random_clifford_circuit(num_qubits, depth, rng)

# Build the full stabilizer group, then sample from it uniformly at random
circ_no_meas = circuit.remove_final_measurements(inplace=False)
stabilizer_group = PauliList([Pauli("I" * num_qubits)])
for generator in (
    Pauli(label) for label in Clifford(circ_no_meas).to_labels(mode="S")
):
    stabilizer_group = stabilizer_group + stabilizer_group.compose(generator)

keep = np.where(
    stabilizer_group.x.any(axis=1) | stabilizer_group.z.any(axis=1)
)[0]
chosen = np.random.default_rng(seed).choice(
    keep, size=min(num_stabilizers, len(keep)), replace=False
)
stabilizers = [stabilizer_group[int(i)] for i in chosen]

two_qubit_depth = circuit.depth(lambda x: x.operation.num_qubits == 2)
print(
    f"Sampled {len(stabilizers)} stabilizers of a {circuit.num_qubits}-qubit "
    f"circuit with two-qubit depth {two_qubit_depth}: "
    f"{{{stabilizers[0]}, {stabilizers[1]}, ...}}"
)
Sampled 20 stabilizers of a 12-qubit circuit with two-qubit depth 24: {ZXIIXZYYXIZZ, XXXYIIZYXIII, ...}
Untuk setiap stabilizer yang disampel, putarkan litar supaya stabilizer diukur dalam asas pengiraan, transpile ia ke atas backend, dan cari set pemeriksaan yang baik. Pasangan sasaran dan ancilla dikocok bersama untuk setiap stabilizer supaya setiap sasaran mengekalkan ancillanya. Ingat bahawa pemeriksaan disahkan secara berurutan mengikut urutan qubit sasaran diberikan, dan pemeriksaan yang telah disahkan tidak berubah apabila lebih banyak pemeriksaan ditambah.
noisy_circuits = []
checked_circuits = []
depths_2q = []
t0 = time.time()
for i, pauli in enumerate(tqdm(stabilizers)):
    noisy_circuits.append(pm.run(append_basis_rotation(circuit, pauli)))
    # Shuffle target and ancilla pairs together so each target keeps its ancilla
    targets, ancillas = zip(
        *random.sample(
            list(zip(target_qubits, ancilla_qubits, strict=True)),
            k=len(target_qubits),
        ),
        strict=True,
    )
    checked_circuits.append(
        add_pauli_checks(
            noisy_circuits[-1],
            list(targets),
            noise_model,
            ancilla_qubits=list(ancillas),
            cost="gamma",
            method="windowed",
            seed=seed + 1 + i,
        )
    )
    depths_2q.append(
        checked_circuits[-1][-1].circuit.depth(lambda x: len(x.qubits) == 2)
    )

print(
    f"Added {num_checks} checks to {len(stabilizers)} circuits "
    f"in {(time.time() - t0):.0f}s."
)
print(
    f"On average, two-qubit depth increased from "
    f"{circuit.depth(lambda x: len(x.qubits) == 2)} to {int(np.mean(depths_2q))} "
    f"when adding {num_checks} checks."
)
100%|██████████| 20/20 [00:15<00:00, 1.29it/s]
Added 7 checks to 20 circuits in 15s.
On average, two-qubit depth increased from 24 to 33 when adding 7 checks.
Sampel payload asal dan litar yang diperiksa dengan Qiskit Aer. Simulator menggunakan model depolarisasi yang sama yang menilai pemeriksaan, jadi hingar yang disasarkan oleh pemeriksaan adalah hingar yang digunakan oleh simulator.
aer_nm = AerNoiseModel()
aer_nm.add_all_qubit_quantum_error(
    depolarizing_error(noise_model.gate_noise, 2), ["cz"]
)
p = noise_model.readout_noise
aer_nm.add_all_qubit_readout_error(ReadoutError([[1 - p, p], [p, 1 - p]]))
noisy_sim = AerSimulator(method="stabilizer", noise_model=aer_nm)

counts = []
for i, checked_circ_result in enumerate(tqdm(checked_circuits)):
    noisy_counts = (
        noisy_sim.run(
            noisy_circuits[i], shots=num_shots, seed_simulator=seed * i + 1
        )
        .result()
        .get_counts()
    )
    checked_counts_per_variant = []
    for k, ck in enumerate(checked_circ_result):
        variant_counts = (
            noisy_sim.run(
                ck.circuit, shots=num_shots, seed_simulator=seed * i + 2 + k
            )
            .result()
            .get_counts()
        )
        checked_counts_per_variant.append(variant_counts)
    counts.append((noisy_counts, checked_counts_per_variant))
100%|██████████| 20/20 [00:17<00:00, 1.13it/s]
Langkah 4: Pasca-proses dan kembalikan hasil dalam format klasik yang dikehendaki
Setiap pemeriksaan menggunakan get pengikat antara satu ancilla dan satu sasaran. Ancilla bermula dalam , jadi menstabilkan inputnya. Merambatkan ke hadapan melalui litar yang diperiksa menghasilkan operator Pauli pada output yang terma bukan-identiti menentukan sokongan pemeriksaan. Pemeriksaan lulus apabila bit dalam sokongannya mempunyai pariti genap. Sampel hanya dikekalkan apabila setiap pemeriksaan lulus.
get_postselection_method bagi setiap CheckedCircuit mengembalikan fungsi yang memetakan bitstring yang diukur kepada vektor sindrom. Simpan sampel yang sindromnya sifar untuk setiap pemeriksaan, dan buang selebihnya. Carta yang berikut menunjukkan bahawa menambah lebih banyak pemeriksaan menurunkan kadar pascapilihan. Kadar pascapilihan yang lebih rendah memerlukan lebih banyak tembakan untuk mencapai ketepatan sasaran, jadi terdapat tradeoff antara keupayaan pengesanan dan kos pensampelan. Kadar itu kelihatan menumpu, yang menunjukkan bahawa pemeriksaan tambahan menyumbang keupayaan pengesanan yang lebih sedikit.
rate_per_variant = []
kept_per_stab = []
for i, (_, checked_counts_per_variant) in enumerate(counts):
    rates = []
    kept_at_num_checks = None
    for k, variant_counts in enumerate(checked_counts_per_variant):
        ps_fn = checked_circuits[i][k].get_postselection_method()
        kept = {
            bs: n for bs, n in variant_counts.items() if not ps_fn(bs).any()
        }
        rates.append(sum(kept.values()) / num_shots)
        if k == num_checks:
            kept_at_num_checks = kept
    rate_per_variant.append(rates)
    kept_per_stab.append(kept_at_num_checks)

max_len = max(len(s) for s in rate_per_variant)
rates_arr = np.full((len(rate_per_variant), max_len), np.nan)
for i, s in enumerate(rate_per_variant):
    rates_arr[i, : len(s)] = s
ks = np.arange(max_len)

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(ks, rates_arr.T, color="#ff8c00", alpha=0.15, linewidth=1)
ax.plot(
    ks,
    np.nanmedian(rates_arr, axis=0),
    color="black",
    linewidth=1,
    linestyle="--",
    label="median",
)
ax.set_xlabel("Checks committed")
ax.set_ylabel("Postselection rate")
ax.set_ylim((0, 1.05))
ax.set_title(
    f"Per-stabilizer postselection rate ({len(rates_arr)} stabilizers)"
)
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

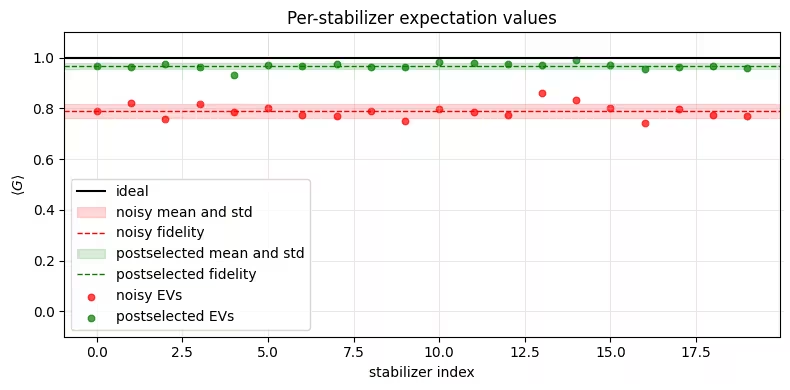
Sekarang bandingkan kesetiaan keadaan hingar asal dengan keadaan pascapilih. Pascapilihan hanya sampel yang tiada ralat dikesan meningkatkan nilai jangkaan setiap stabilizer, dan seterusnya kesetiaan yang dianggarkan. Nilai pascapilih menggunakan lebih sedikit sampel berbanding nilai asal, namun nilai jangkaan lebih tepat dan varians yang disampel lebih rendah. Perhatikan juga bahawa kadar pascapilihan purata adalah hampir dengan kesetiaan hingar. Ini adalah yang dijangkakan apabila pemeriksaan mengesan hampir semua sampel berralat: pecahan sampel yang lulus setiap pemeriksaan menghampiri pecahan sampel bebas ralat, iaitu kesetiaan keadaan hingar.
results = []
for i, ((noisy_counts, _), kept) in enumerate(
    zip(counts, kept_per_stab, strict=True)
):
    results.append(
        (
            expectation(noisy_counts, stabilizers[i]),
            expectation(kept, stabilizers[i]),
            sum(kept.values()) / num_shots,
        )
    )

fidelity_noisy = float(np.nanmean([r[0] for r in results]))
fidelity_postsel = float(np.nanmean([r[1] for r in results]))
psr = float(np.mean([r[2] for r in results]))
print(
    f"ideal fidelity:          1.0\n"
    f"noisy fidelity:          {fidelity_noisy:.4f}\n"
    f"postselected fidelity:   {fidelity_postsel:.4f}\n"
    f"mean postselection rate: {psr:.3f}"
)

evs_ideal = np.ones(len(results))
evs_noisy = np.array([r[0] for r in results])
evs_post = np.array([r[1] for r in results])
idx = np.arange(len(results))

def strip(ax, ys, color, label):
    m, s = np.nanmean(ys), np.nanstd(ys)
    ax.axhspan(
        m - s, m + s, color=color, alpha=0.15, label=f"{label} mean and std"
    )
    ax.axhline(
        m, color=color, linewidth=1, linestyle="--", label=f"{label} fidelity"
    )

fig, ax = plt.subplots(figsize=(8, 4))
ax.axhline(np.nanmean(evs_ideal), color="black", linewidth=1.5, label="ideal")
strip(ax, evs_noisy, "red", "noisy")
strip(ax, evs_post, "green", "postselected")
ax.scatter(idx, evs_noisy, color="red", s=22, alpha=0.7, label="noisy EVs")
ax.scatter(
    idx,
    evs_post,
    color="green",
    s=22,
    alpha=0.7,
    label="postselected EVs",
)
ax.set_xlabel("stabilizer index")
ax.set_ylabel(r"$\langle G \rangle$")
ax.set_ylim((-0.1, 1.1))
ax.set_title("Per-stabilizer expectation values")
ax.legend(loc="lower left")
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

M = np.arange(1, len(results) + 1)
fig, ax = plt.subplots(figsize=(8, 4))
for ys, color, label in [
    (evs_ideal, "black", "ideal"),
    (evs_noisy, "red", "noisy"),
    (evs_post, "green", "postselected"),
]:
    cm, sem = cum_mean_sem(ys)
    ax.plot(M, cm, color=color, linewidth=1.5, label=label)
    ax.fill_between(M, cm - sem, cm + sem, color=color, alpha=0.15)
ax.set_xlabel("number of stabilizers averaged")
ax.set_ylabel("running fidelity estimate")
ax.set_title("Fidelity convergence versus number of stabilizers")
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
ideal fidelity:          1.0
noisy fidelity:          0.7899
postselected fidelity:   0.9679
mean postselection rate: 0.780

Skor gamma melaporkan berapa banyak saluran hingar yang dimodelkan masih tidak dikesan oleh pemeriksaan. Memplot skor gamma berbanding bilangan pemeriksaan yang disahkan menunjukkan bagaimana keupayaan pengesanan bertambah baik apabila setiap pemeriksaan ditambah. Nilai 1.0 bermaksud pemeriksaan menangkap semua hingar yang dimodelkan. Lengkung menurun ke arah 1.0 apabila lebih banyak pemeriksaan disahkan, yang menunjukkan bahawa setiap pemeriksaan tambahan menangkap sebahagian daripada ralat yang belum dikesan.
stab_scores = [
    [variant.cost for variant in checked_circ_result]
    for checked_circ_result in checked_circuits
]
max_len = max(len(s) for s in stab_scores)
scores = np.full((len(stab_scores), max_len), np.nan)
for i, s in enumerate(stab_scores):
    scores[i, : len(s)] = s
ks = np.arange(max_len)

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(ks, scores.T, color="#4682b4", alpha=0.15, linewidth=1)
ax.plot(
    ks,
    np.nanmedian(scores, axis=0),
    color="black",
    linewidth=1,
    linestyle="--",
    label="median",
)
ax.set_xlabel("Checks committed")
ax.set_ylabel("Gamma")
ax.set_yscale("log")
ax.set_title(f"Per-stabilizer gamma curves ({len(scores)} stabilizers)")
ax.legend()
ax.grid(True, alpha=0.3, which="both")
plt.tight_layout()
plt.show()

Contoh perkakasan berskala besar
Aliran kerja yang sama berjalan pada perkakasan dengan payload yang lebih besar dan lebih dalam. Bahagian ini menggunakan semula backend daripada contoh simulator tetapi membina susun atur 20-qubit baharu dengan pasangan sasaran dan ancilla serta pengurus laluan tersendiri, kemudian menghantar litar ke QPU dalam satu tugasan. Pada saiz ini, kebanyakan tembakan mencetuskan sekurang-kurangnya satu pemeriksaan, jadi kadar pascapilihan rendah, dan setiap litar memerlukan bajet tembakan yang besar untuk cukup sampel bertahan. Contoh ini oleh itu memberi tumpuan bajetnya kepada beberapa stabilizer yang disampel; ini masih anggaran kesetiaan tidak bias, tetapi lebih kasar berbanding purata contoh simulator ke atas banyak stabilizer.
Satu perkara berubah berbanding contoh simulator: bukannya mengekstrapolasikan saluran depolarisasi seragam daripada data penentukuran, bahagian ini mempelajari model hingar dengan NoiseLearner dan membina model qiskit-paulice daripada hasil dengan NoiseModel.from_pauli_lindblad_maps. Model Pauli-Lindblad yang dipelajari menangkap struktur ruang hingar pada susun atur khusus ini, bukannya menganggap setiap tepi sama-sama berhingar, jadi penempatan pemeriksaan dinilai berbanding hingar yang lebih mirip dengan yang mempengaruhi QPU. Mempelajari hingar memerlukan pensampelan QPU dan perlu diambil kira dalam mana-mana bajet pensampelan QPU keseluruhan.
Parameter yang berikut menetapkan bilangan qubit, kedalaman, bilangan stabilizer, dan bilangan tembakan. Skalakan hw_num_shots dengan songsang kadar pascapilihan: pada kadar 3%, 40,000 tembakan meninggalkan kira-kira 1,200 sampel pascapilih setiap litar. Tingkatkan hw_num_stabilizers untuk anggaran kesetiaan yang lebih tepat dengan kos litar yang lebih banyak setiap tugasan, setiap satu memerlukan bajet tembakan yang sama.
Langkah 1-4 (dimampatkan ke dalam satu blok kod)
Sel yang berikut menjalankan empat langkah yang sama seperti contoh simulator. Ia membina payload yang lebih besar dan mensampel beberapa stabilizer (langkah 1); memilih susun atur, mempelajari model hingar padanya, dan mencari litar yang diperiksa sepenuhnya untuk setiap stabilizer (langkah 2); menghantar satu tugasan Sampler yang mengandungi kedua-dua litar asal dan yang diperiksa (langkah 3); dan pascapilih kiraan yang diperiksa untuk membandingkan anggaran kesetiaan hingar dan pascapilih, setiap stabilizer dan secara purata (langkah 4). Pada saiz ini, menyenaraikan keseluruhan kumpulan stabilizer seperti contoh simulator adalah tidak praktikal, jadi sel ini mensubsampel subset rawak stabilizer untuk mengira anggaran kesetiaan.
Perhatikan bahawa langkah 2 melakukan lebih banyak di sini berbanding dalam contoh simulator: mempelajari model hingar menghantar tugasan NoiseLearnernya sendiri sebelum tugasan Sampler, jadi sel ini menjalankan dua tugasan secara keseluruhan. Mereka membawa tag TUT_ASPC_LEARN dan TUT_ASPC supaya anda boleh mencarinya kemudian. Lihat Susun dan cari mengikut tag tugasan untuk maklumat lanjut mengenai penandaan tugasan.
# -------------------------Step 1: build a larger payload and sample stabilizers-------------------------
hw_num_qubits = 20
hw_depth = 36
hw_num_stabilizers = 10
hw_num_shots = 40_000

hw_circuit = random_clifford_circuit(hw_num_qubits, hw_depth, rng)
hw_no_meas = hw_circuit.remove_final_measurements(inplace=False)

# Enumerating all 2^n stabilizers is infeasible at this size, so draw each
# stabilizer by composing a random subset of the group generators
hw_generators = [
    Pauli(label) for label in Clifford(hw_no_meas).to_labels(mode="S")
]
sample_rng = np.random.default_rng(seed)
hw_stabilizers = []
while len(hw_stabilizers) < hw_num_stabilizers:
    mask = sample_rng.integers(0, 2, hw_num_qubits).astype(bool)
    if not mask.any():
        continue  # skip the identity
    stabilizer = Pauli("I" * hw_num_qubits)
    for generator, chosen in zip(hw_generators, mask, strict=True):
        if chosen:
            stabilizer = stabilizer.compose(generator)
    hw_stabilizers.append(stabilizer)

# -------------------------Step 2: find a 20-qubit layout, learn its noise, and add checks-------------------------
# A single bad coupler or bad-readout qubit on the path drags every
# stabilizer down, so search harder and with tighter error thresholds
hw_layout = find_check_layout(
    backend,
    hw_num_qubits,
    rng,
    num_trials=500,
    max_gate_error=0.015,
    max_readout_error=0.05,
)
hw_target_qubits, hw_ancilla_qubits = get_check_qubits(backend, hw_layout)
hw_pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=hw_layout
)
print(f"Layout with {len(hw_target_qubits)} check pairs: {hw_layout}")

# ----- learn a Pauli-Lindblad noise model on this layout -----
# The simulator example scored checks against a uniform depolarizing channel
# inferred from calibration data. Here, learn the noise instead: NoiseLearner
# runs its own job on the QPU and returns a Pauli-Lindblad channel per unique
# entangling layer, so the checks are placed against the noise this layout
# actually has, including its spatial structure. All the sampled stabilizers
# share the same entangling layers and differ only in their final basis
# rotation, so learning on the bare payload covers all of them.
learner = NoiseLearner(
    mode=backend,
    options={
        "max_layers_to_learn": 4,
        "num_randomizations": 32,
        "shots_per_randomization": 128,
        "environment": {"job_tags": ["TUT_ASPC_LEARN"]},
    },
)
learner_job = learner.run([hw_pm.run(hw_circuit)])
print(f"Submitted noise-learner job {learner_job.job_id()}")
hw_layer_errors = learner_job.result().data

# To see how much the learned model helps, swap the next line for the
# simulator example's uniform model - a one-line change:
# hw_noise_model = NoiseModel.from_backend(backend, hw_layout, uniform_gate_noise=True)
hw_noise_model = learned_noise_model(hw_layer_errors, hw_layout)
# NoiseLearner characterizes gate noise only, so keep the readout estimate
# from calibration data rather than leaving it unset
hw_noise_model.readout_noise = NoiseModel.from_backend(
    backend, hw_layout, uniform_gate_noise=True
).readout_noise
print(
    f"Learned {len(hw_layer_errors)} layers; "
    f"readout noise {hw_noise_model.readout_noise:.5f}"
)

# ----- add the fully checked circuit per stabilizer -----
hw_noisy_circuits = []
hw_checked_circuits = []
for i, pauli in enumerate(tqdm(hw_stabilizers)):
    bare = hw_pm.run(append_basis_rotation(hw_circuit, pauli))
    hw_noisy_circuits.append(bare)
    variants = add_pauli_checks(
        bare,
        hw_target_qubits,
        hw_noise_model,
        ancilla_qubits=hw_ancilla_qubits,
        cost="gamma",
        method="windowed",
        seed=seed + 1 + i,
    )
    hw_checked_circuits.append(variants[-1])  # keep the fully checked circuit

# -------------------------Step 3: submit one Sampler job with the bare and checked circuits-------------------------
sampler = Sampler(mode=backend)
sampler.options.default_shots = hw_num_shots
sampler.options.environment.job_tags = ["TUT_ASPC"]

pubs = hw_noisy_circuits + [cc.circuit for cc in hw_checked_circuits]
job = sampler.run(pubs)
print(f"Submitted job {job.job_id()} with {len(pubs)} circuits")

# -------------------------Step 4: postselect and compare fidelity-------------------------
result = job.result()
n_stab = len(hw_stabilizers)

hw_results = []
for i in range(n_stab):
    noisy_counts = result[i].join_data().get_counts()
    checked_counts = result[n_stab + i].join_data().get_counts()
    ps_fn = hw_checked_circuits[i].get_postselection_method()
    kept = {bs: c for bs, c in checked_counts.items() if not ps_fn(bs).any()}
    hw_results.append(
        (
            expectation(noisy_counts, hw_stabilizers[i]),
            expectation(kept, hw_stabilizers[i]),
            sum(kept.values()) / sum(checked_counts.values()),
        )
    )

hw_fidelity_noisy = float(np.nanmean([r[0] for r in hw_results]))
hw_fidelity_postsel = float(np.nanmean([r[1] for r in hw_results]))
hw_psr = float(np.mean([r[2] for r in hw_results]))
print(
    f"noisy fidelity estimate:        {hw_fidelity_noisy:.4f}\n"
    f"postselected fidelity estimate: {hw_fidelity_postsel:.4f}\n"
    f"mean postselection rate:        {hw_psr:.4f} "
    f"(~{int(round(hw_psr * hw_num_shots))} kept shots per circuit)"
)

# Per-stabilizer breakdown. The postselection rate varies from stabilizer to
# stabilizer, so a stabilizer whose postselected value barely moves is usually
# one whose checks rejected little; the kept-shot count says how much of the
# gap is statistics rather than signal.
print("\nper-stabilizer results:")
print(
    f"{'idx':>3}  {'noisy':>8}  {'postsel':>8}  {'psr':>7}  {'kept shots':>10}"
)
for i, (noisy, post, psr_i) in enumerate(hw_results):
    print(
        f"{i:>3}  {noisy:>8.4f}  {post:>8.4f}  {psr_i:>7.4f}  "
        f"{int(round(psr_i * hw_num_shots)):>10}"
    )

hw_noisy = np.array([r[0] for r in hw_results])
hw_post = np.array([r[1] for r in hw_results])
idx = np.arange(n_stab)

fig, ax = plt.subplots(figsize=(9, 4))
ax.axhline(1.0, color="black", linewidth=1.5, label="ideal")
strip(ax, hw_noisy, "red", "noisy")
strip(ax, hw_post, "green", "postselected")
ax.scatter(idx, hw_noisy, color="red", s=22, alpha=0.7, label="noisy EVs")
ax.scatter(
    idx,
    hw_post,
    color="green",
    s=22,
    alpha=0.7,
    label="postselected EVs",
)
ax.set_xlabel("stabilizer index")
ax.set_ylabel(r"$\langle G \rangle$")
ax.set_ylim((-0.1, 1.1))
ax.set_xticks(idx)
ax.set_title("Per-stabilizer expectation values on hardware")
# Outside the axes so it cannot hide a data point
ax.legend(loc="center left", bbox_to_anchor=(1.02, 0.5), frameon=False)
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
Layout with 11 check pairs: [153, 152, 151, 138, 131, 130, 129, 118, 109, 110, 111, 98, 91, 90, 89, 78, 69, 70, 71, 58]
Submitted noise-learner job d9f4mncjeosc73fjfmkg
Learned 4 layers; readout noise 0.00470
100%|██████████| 10/10 [01:01<00:00, 6.18s/it]
Submitted job d9f4s04jeosc73fjftkg with 20 circuits
noisy fidelity estimate:        0.3685
postselected fidelity estimate: 0.6869
mean postselection rate:        0.2851 (~11404 kept shots per circuit)

per-stabilizer results:
idx     noisy   postsel      psr  kept shots
  0    0.3769    0.6918   0.3247       12987
  1    0.3745    0.6760   0.2999       11995
  2    0.3659    0.6389   0.3549       14196
  3    0.3821    0.7060   0.2660       10641
  4    0.3653    0.7475   0.2531       10124
  5    0.3752    0.7022   0.2698       10791
  6    0.3508    0.7144   0.2711       10842
  7    0.3485    0.7087   0.2381        9523
  8    0.3825    0.6289   0.2928       11711
  9    0.3630    0.6549   0.2808       11232

Untuk litar bersaiz ini, kebanyakan sampel mengandungi sekurang-kurangnya satu ralat yang dikesan, jadi kadar pascapilihan kecil dan pascapilihan membuang kebanyakan tembakan. Sampel yang lulus setiap pemeriksaan memberikan nilai jangkaan yang jauh lebih baik berbanding litar asal, dan nilai setiap stabilizer terpisah dengan jelas daripada garis dasar hingar. Untuk mengetatkan anggaran kesetiaan, sampel lebih banyak stabilizer dengan bajet tembakan setiap litar yang sama. Untuk meningkatkan kadar pascapilihan, kurangkan kedalaman litar atau sahkan lebih sedikit pemeriksaan; untuk beralih kepada payload yang lebih besar, skalakan bajet tembakan dengan songsang kadar pascapilihan.
Langkah seterusnya
Jika anda mendapati kerja ini menarik, anda mungkin berminat dengan bahan berikut:
-
Tutorial mengenai kod pengulangan untuk pengenalan kepada pembetulan ralat kuantum.
-
Dokumentasi
qiskit-pauliceuntuk API mencari pemeriksaan yang lengkap, dan repositori GitHub pakej ini untuk kod sumber. -
Kertas kerja Pengesanan ralat overhead rendah dengan kod spacetime untuk teori di sebalik pemeriksaan.
Rujukan
-
[1] Martiel, S., & Javadi-Abhari, A. (2025). Low-overhead error detection with spacetime codes. arXiv preprint arXiv:2504.15725.
-
[2] van den Berg, E., Bravyi, S., Gambetta, J. M., Jurcevic, P., Maslov, D., & Temme, K. (2023). Single-shot error mitigation by coherent Pauli checks. Physical Review Research, 5(3), 033193.