Pengurangan ralat
Pelajaran ini menyediakan latar belakang tentang pelbagai teknik pengurangan ralat untuk membantu pengguna membina intuisi tentang cara dan masa teknik tersebut paling sesuai digunakan. Yang penting, aplikasi moden bagi teknik-teknik ini akan memanfaatkan alat yang lebih canggih, seperti Samplomatic, Shaded Lightcones, dan Executor. Aliran kerja tersebut akan dibincangkan dalam pelajaran kemudian.
Video ini memberikan gambaran keseluruhan teknik pengurangan ralat. Teks di bawah menambah lebih banyak butiran dan meneroka kaedah-kaedah ini menggunakan Qiskit.
Gambaran keseluruhan teknik pengurangan ralat
Pengurangan ralat merujuk kepada sebarang proses yang cuba mengurangkan kesan ralat dalam pengiraan kuantum selepas ralat itu berlaku. Ia berbeza daripada penindasan, yang cuba mencegah ralat, dan daripada pembetulan ralat, yang mengekod maklumat merentasi banyak qubit fizikal dan menyemak ketekalan maklumat tersebut untuk memelihara maklumat dalam satu qubit logik. Sepanjang pelajaran ini, teknik pengurangan ralat paling baik difahami sebagai kaedah untuk membina penganggar jangkaan nilai unggul yang lebih baik atau pensampel taburan kebarangkalian yang lebih baik, bukan sebagai kaedah untuk membetulkan keadaan kuantum semasa pelaksanaan. Kita akan meneliti kaedah pengurangan ralat di bawah, yang kesemuanya tersedia dalam Qiskit dan addon-nya, dan merupakan alat yang menjanjikan dalam usaha mencapai kelebihan kuantum.
Twirled readout error extinction (TREX) merawakkan proses pengukuran dengan menggunakan operasi Pauli yang dipilih secara rawak sebelum pengukuran dan kemudian membatalkan kesan yang diketahui itu secara klasik pada rentetan bit yang diperhatikan. Di bawah andaian hingar pengukuran yang sesuai, ini menukar saluran ralat bacaan kepada bentuk yang lebih ringkas dan lebih simetri yang lebih mudah ditentukur dan dikurangkan.
Matrix-free measurement mitigation (M3) ialah teknik pengurangan ralat pengukuran berskala yang mengelakkan pembinaan matriks penugasan atau songsangannya secara eksplisit.
Zero noise extrapolation (ZNE) menganggarkan nilai yang akan dimiliki oleh suatu observable tanpa hingar dengan menskalakan hingar secara buatan mengikut faktor yang diketahui dan mengekstrapolasi kembali kepada kes hingar sifar. Ini memerlukan hingar berskala dengan cara yang boleh diramal. Kebolehramalan itu mungkin memerlukan kaedah lain yang dibincangkan dalam pelajaran ini (regangan denyut, pelipatan gate, dan penguatan ralat probabilistik (PEA)).
Probabilistic error cancellation (PEC) ialah antara teknik pengurangan ralat yang paling berkuasa, tetapi juga paling mahal dari segi pengiraan. Ia berfungsi dengan mempelajari tingkah laku hingar sistem dan cuba membatalkan hingar itu dengan membina anggaran tidak berat sebelah bagi pengiraan unggul secara statistik. PEC menghasilkan observable yang dibetulkan secara statistik, bukan keputusan yang dibetulkan ralatnya.
Kita kini akan mendalami setiap kaedah ini.
M3
Ralat pengukuran ialah salah satu sumber hingar yang paling berterusan dan khusus perkakasan dalam peranti kuantum jangka dekat. Walaupun keadaan kuantum disediakan dan berkembang dengan betul, langkah bacaan akhir boleh tersalah melaporkan hasil asas pengiraan yang sebenar. Ralat ini timbul daripada pembezaan tidak sempurna antara keadaan fizikal yang sepadan dengan dan , relaksasi semasa pengukuran, dan ketidaksempurnaan dalam elektronik pengukuran. Akibatnya, taburan rentetan bit yang diperhatikan selalunya versi herot bagi taburan sebenar (unggul), dengan kebarangkalian ditugaskan semula secara tidak betul antara hasil.
Pengurangan pengukuran menangani masalah ini dengan memodelkan secara eksplisit bagaimana hasil pengukuran tersalah ditugaskan. Dalam formulasi piawai, tingkah laku ini ditangkap oleh matriks penugasan , yang unsurnya mewakili kebarangkalian merekodkan hasil apabila keadaan asas sebenar ialah . Jika hingar pengukuran bersifat klasik dan pegun, vektor kebarangkalian yang diperhatikan berkaitan dengan taburan unggul melalui hubungan linear yang ringkas,
Perhatikan bahawa matriks penugasan ialah peta stokastik klasik, bukan saluran kuantum. Ia bertindak pada bacaan klasik, bukan pada keadaan kuantum asas yang disampel untuk mendapatkan bacaan tersebut.
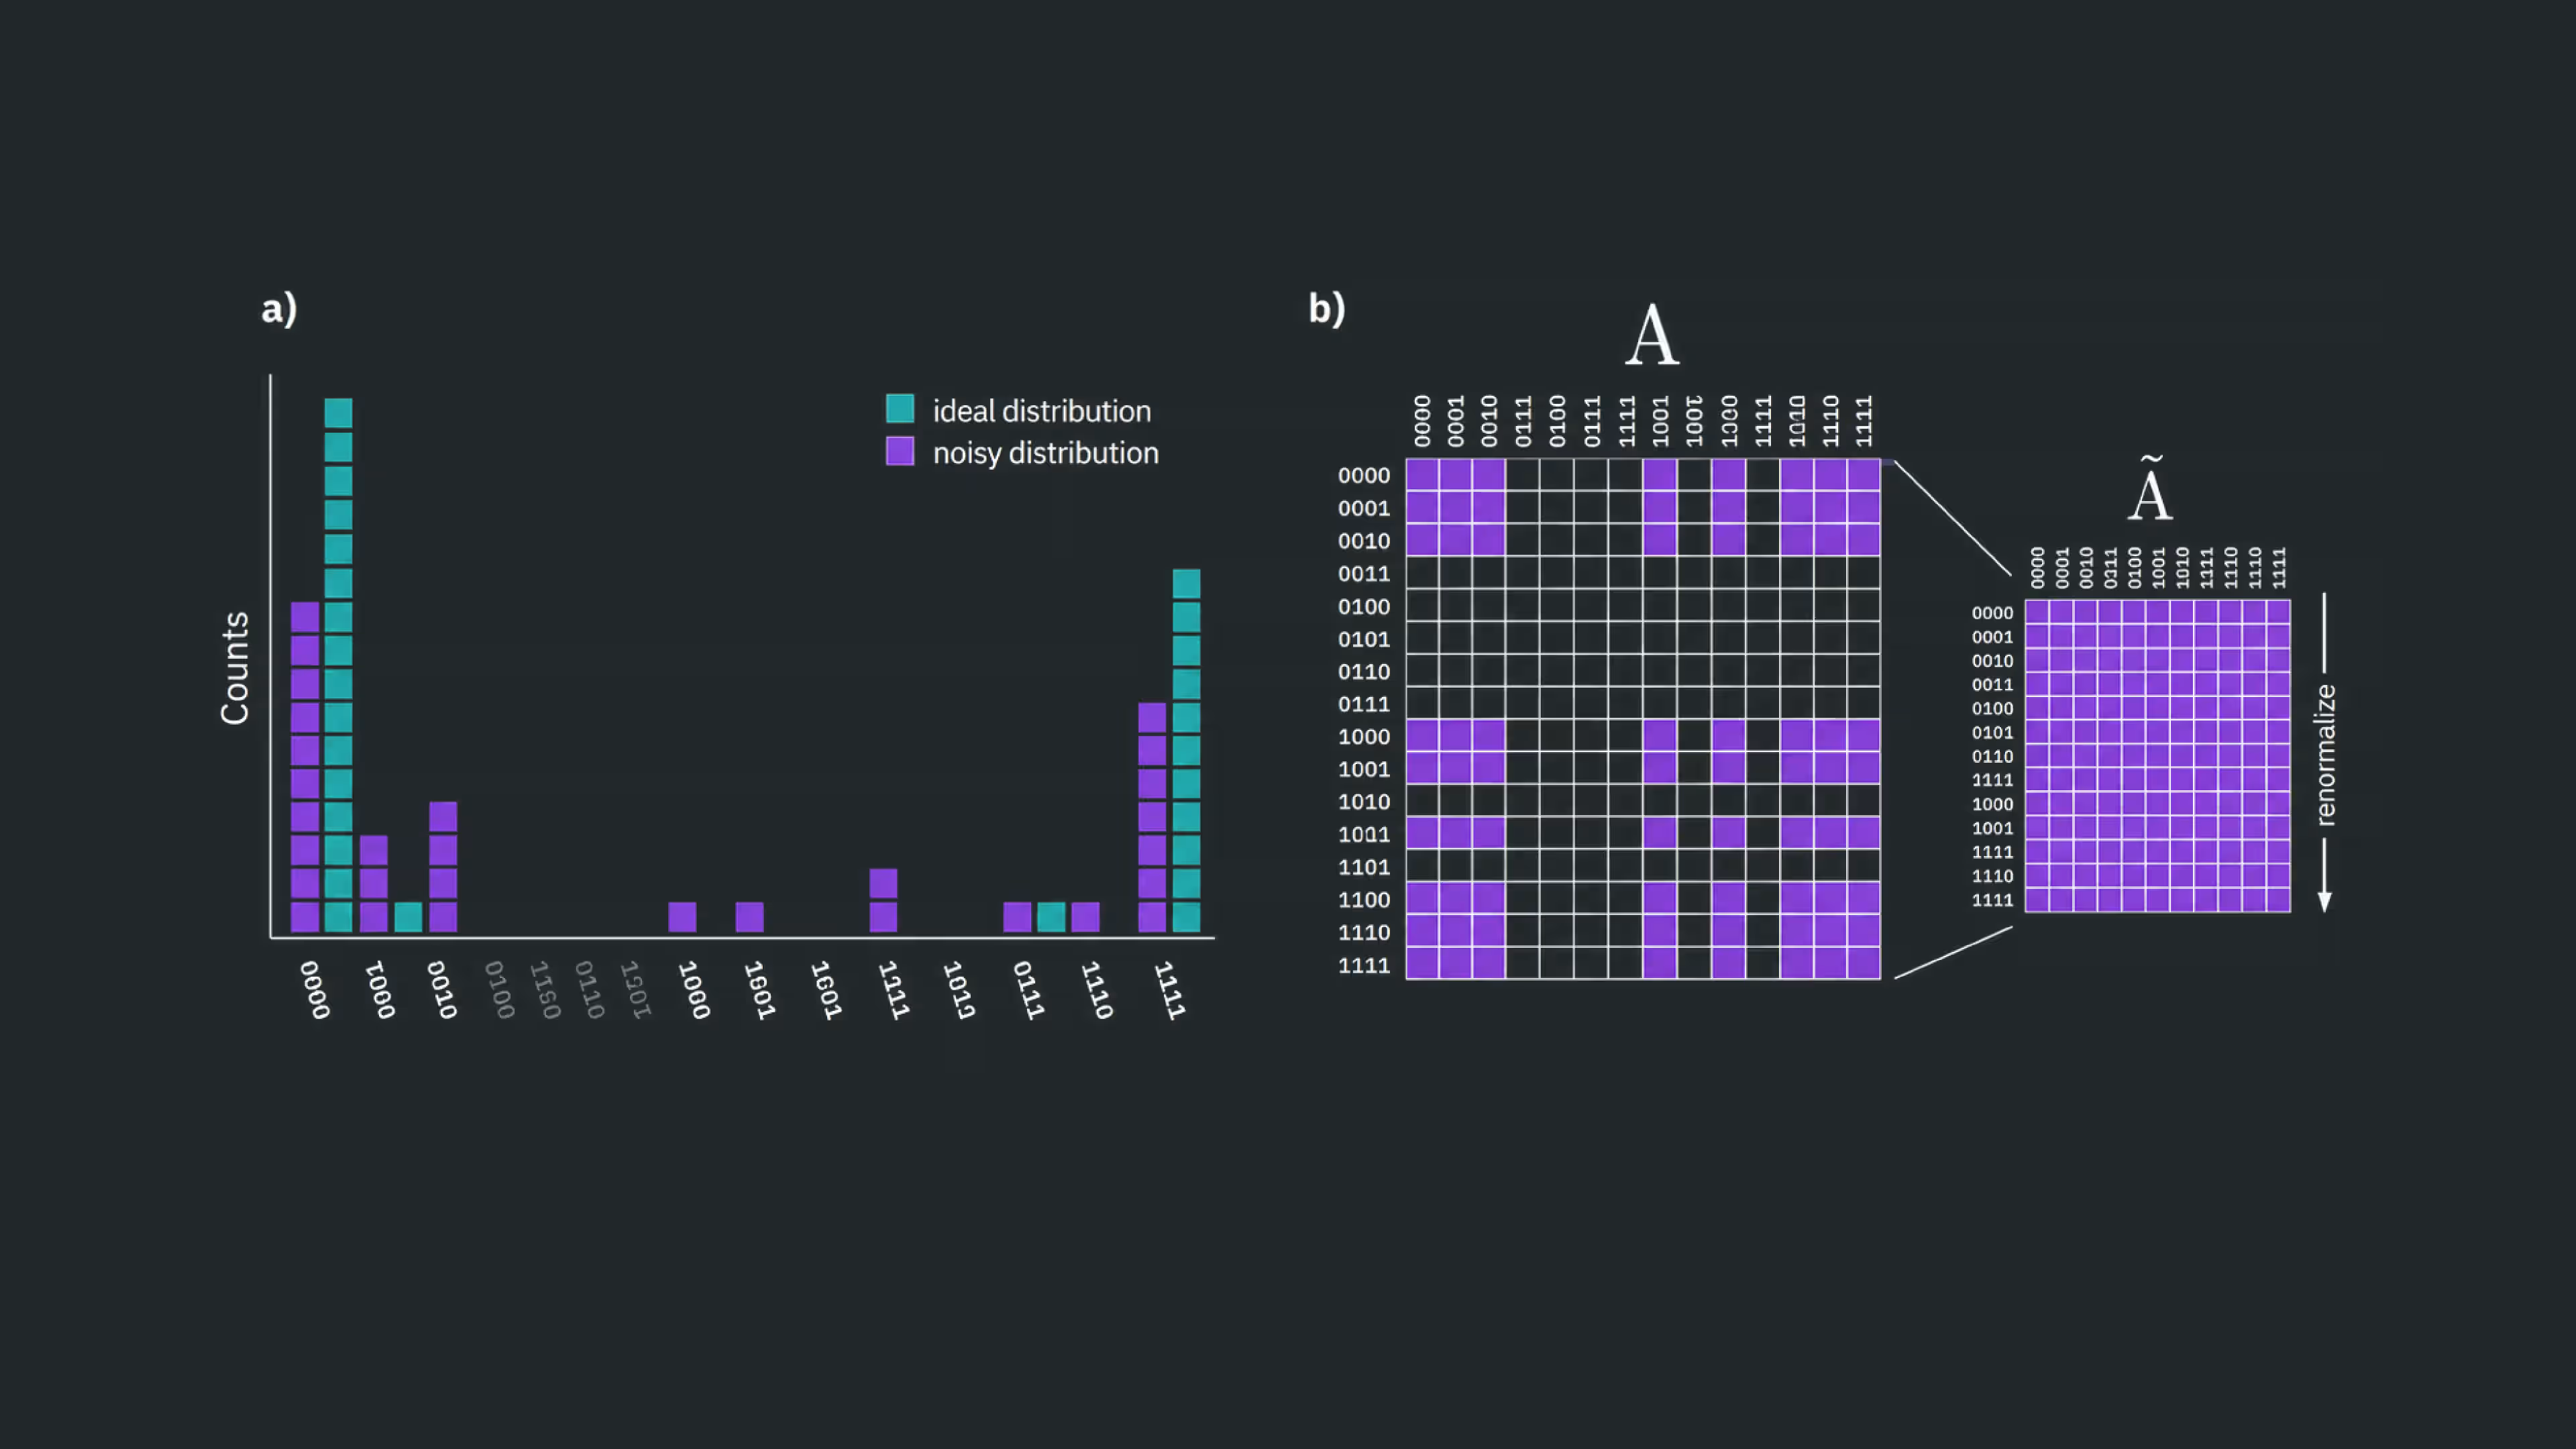
Matrix-free measurement mitigation (M3) menggunakan struktur ini untuk membina anggaran terkurang bagi tanpa pernah membentuk atau menyongsangkan matriks penuh , yang mustahil dilakukan untuk bilangan qubit yang besar. Sebaliknya, M3 memanfaatkan hakikat bahawa banyak beban kerja kuantum jangka dekat menghasilkan taburan yang sangat memuncak atau berentropi rendah, sehingga pengurangan hanya tertumpu pada subset hasil yang menyumbang dengan ketara kepada taburan yang diperhatikan.
Untuk membina model penugasan, eksperimen penentukuran tambahan mesti dijalankan pada perkakasan kuantum. Ini lazimnya melibatkan penyediaan keadaan asas pengiraan yang diketahui dan merekodkan cara keadaan itu dilaporkan oleh sistem pengukuran. Overhed penentukuran berskala dengan bilangan qubit yang diukur, manakala kos pengiraan pengurangan bergantung pada struktur taburan yang diperhatikan. Kos ini jauh lebih kecil daripada yang diperlukan untuk mencirikan matriks penugasan penuh secara eksplisit. Walaupun overhed penentukuran ini wujud, ia ringan berbanding teknik peringkat litar seperti zero-noise extrapolation atau probabilistic error cancellation, menjadikan M3 alat yang praktikal dan digunakan secara meluas untuk mengurangkan ralat bacaan dalam eksperimen kuantum jangka dekat.
Perhatikan bahawa penentukuran hanya berguna setakat proses pengukuran kekal cukup stabil antara larian penentukuran dan eksperimen sasaran.
Kita mula-mula akan melaksanakan kes ringkas secara manual untuk menggambarkan cara ia berfungsi, kemudian menggunakan alat terbina dalam Qiskit untuk menunjukkan penggunaan M3 pada skala yang lebih realistik.
Contoh kecil M3
Kita bermula dengan membina keadaan Bell yang ringkas.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "mthree": "mthree", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
import numpy as np

qc = QuantumCircuit(2, 2)
qc.h(0)
qc.cx(0, 1)
qc.measure([0, 1], [0, 1])
<qiskit.circuit.instructionset.InstructionSet at 0x714a5fa4d630>
Kita boleh menggunakan simulator dengan model hingar kerana kita mengehadkan contoh ini kepada litar yang sangat kecil. Kita mengkonfigurasi model hingar kita secara eksplisit supaya mempunyai ralat bacaan dalam bentuk:
if true=0: [95% chance of reading 0, 5% chance of reading 1]
if true=1: [8% chance of reading 0, 92% chance of reading 1]
Kadar ralat bacaan ini jauh lebih tinggi daripada yang dilihat pada komputer kuantum IBM® sebenar. Nilai tinggi ini dipilih atas sebab pedagogi, supaya kita dapat melihat dengan jelas kesan M3.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, ReadoutError

ro_error = ReadoutError([[0.95, 0.05], [0.08, 0.92]])

noise_model = NoiseModel()
noise_model.add_readout_error(ro_error, [0])
noise_model.add_readout_error(ro_error, [1])

backend_noisy = AerSimulator(noise_model=noise_model)
Kita boleh menjalankan litar pada simulator berhingar untuk memerhatikan kesan ralat bacaan.
result = backend_noisy.run(qc, shots=5000, seed_simulator=123).result()
raw_counts = result.get_counts()
raw_counts
{'01': 290, '11': 2165, '10': 304, '00': 2241}
Dalam contoh mainan kita, kita mentakrifkan ralat bacaan untuk model hingar kita. Tetapi apabila menggunakan komputer kuantum sebenar, ralat bacaan tidak diketahui secara a priori. Sebaliknya, ia mesti dianggarkan secara eksperimen. Untuk ini, kita mencipta litar untuk menyediakan qubit dalam keadaan asas pengiraan yang diketahui atau dan mengukurnya. Tanpa ralat bacaan, kita akan mengukur tepat keadaan yang disediakan. Dengan mengumpul statistik daripada pengukuran ini, kita boleh membina matriks penugasan yang menerangkan ralat bacaan. Dalam contoh mainan ini, ia sepatutnya kelihatan serupa dengan yang kita takrifkan.
Untuk sistem yang lebih realistik, statistik perlu dikumpulkan bagi setiap qubit fizikal. Ini kadangkala tidak mudah, kerana transpilasi memetakan litar abstrak kepada perkakasan dan nombor qubit berubah. Kita akan menyemak semula perkara ini dalam contoh seterusnya. Dalam contoh simulator ini, kita menugaskan model ralat bacaan yang sama kepada setiap qubit, jadi satu pencirian sudah memadai.
# Define a function to make a state and measure it.
def measure_state(state):
    qc = QuantumCircuit(1, 1)
    if state == 1:
        qc.x(0)
    qc.measure(0, 0)
    return backend_noisy.run(qc, shots=5000, seed_simulator=123).result().get_counts()
# Use the function to get statistics on readout errors
cal_counts_0 = measure_state(0)  # True state = 0
cal_counts_1 = measure_state(1)  # True state = 1

cal_counts_0, cal_counts_1
({'1': 244, '0': 4756}, {'0': 420, '1': 4580})
# Create the normalized readout error matrix

# def normalize(d):
#    s = sum(d.values())
#    return {k: v/s for k,v in d.items()}
# p0 = normalize(cal_counts_0)
# p1 = normalize(cal_counts_1)

p0 = {k: v / sum(cal_counts_0.values()) for k, v in cal_counts_0.items()}
p1 = {k: v / sum(cal_counts_1.values()) for k, v in cal_counts_1.items()}

A_1q = np.array(
    [
        [p0["0"], p1["0"]],  # row: measured 0, columns true 0/1
        [p0["1"], p1["1"]],
    ]
)
A_1q
array([[0.9512, 0.084 ],
       [0.0488, 0.916 ]])
Perhatikan bahawa ini sangat hampir dengan matriks ralat bacaan yang digunakan untuk membina simulator.
Sekali lagi, pada komputer kuantum sebenar kita akan mempunyai statistik seperti ini untuk berbilang qubit fizikal. Bagi simulator ini, kita menganggap kedua-dua qubit mempunyai ralat bacaan yang serupa dan bebas, membolehkan kita membina matriks penugasan dua-qubit A_2q sebagai hasil darab tensor matriks satu-qubit yang sepadan. Perhatikan juga bahawa tujuan M3 ialah bukan untuk membina keseluruhan matriks penugasan. Sebaliknya, M3 menumpukan pada subset hasil yang menyumbang dengan ketara kepada taburan yang diperhatikan. Kita akan membina keseluruhan matriks untuk contoh kita yang sangat kecil ini bagi melihat cara ia berfungsi. Pelaksanaan M3 dalam qiskit-ibm-runtime lebih canggih daripada contoh mainan ini kerana ia mesti mengendalikan banyak qubit dengan ciri bacaan yang berbeza sambil tetap mengelakkan pembinaan matriks penugasan penuh.
A_2q = np.kron(A_1q, A_1q)
print(A_2q)
[[0.89794576 0.07107    0.07107    0.005625  ]
 [0.04965424 0.87653    0.00393    0.069375  ]
 [0.04965424 0.00393    0.87653    0.069375  ]
 [0.00274576 0.04847    0.04847    0.855625  ]]
Untuk contoh ini kita menganggap ralat bacaan pada qubit berbeza adalah bebas, membolehkan matriks penugasan dua-qubit dibina sebagai hasil darab tensor matriks satu-qubit yang sepadan.
Kita memperoleh keputusan mentah dan terkurang untuk perbandingan.
bitstrings = ["00", "01", "10", "11"]
# Normalize raw counts
raw_probs = np.array([raw_counts.get(b, 0) for b in bitstrings], dtype=float)
raw_probs /= raw_probs.sum()
raw_probs
array([0.4482, 0.0592, 0.0598, 0.4328])
Pada ketika ini, kita telah mencirikan secara eksperimen cara proses pengukuran memesongkan kebarangkalian hasil unggul. Matlamat kita sekarang ialah membatalkan herotan ini dan menggunakan pembetulan yang terhasil pada kebarangkalian mentah.
Oleh kerana kita melakukan penyongsangan linear dan bukannya pembetulan fizikal, "kebarangkalian" yang terhasil tidak semestinya sentiasa positif. Kuasi-kebarangkalian negatif yang sangat kecil dijangka dan mencerminkan hakikat bahawa pengurangan pengukuran menghasilkan penganggar dan bukannya taburan kebarangkalian fizikal.
# Explicit inversion is feasible only for very small systems
# This is why M3 avoids creating the entire A matrix.

A_inv = np.linalg.inv(A_2q)

# Note: mitigated_probs might contain negative values.
# This is expected and reflects estimator, not physical, probabilities.

mitigated_probs = A_inv @ raw_probs
print(mitigated_probs)
[ 4.96000451e-01 -4.69852308e-04 2.17747967e-04 5.04251654e-01]
Kita menukarkannya kepada kiraan untuk diplot.
shots = sum(raw_counts.values())  # e.g., 5000
ideal_probs = [0.50, 0.00, 0.00, 0.50]  # ideal Bell distribution
# Convert probabilities to integer counts for plotting only.
# Not physically meaningful when probabilities are negative

def probs_to_counts(bitstrings, probs, shots):
    """
    Convert a probability vector into a Qiskit-style counts dictionary.
    Ensures integer shot counts and correct normalization.
    """
    counts = {}
    # First convert to raw integer counts
    int_counts = [round(p * shots) for p in probs]
    # Fix rounding error by adjusting the last entry
    diff = shots - sum(int_counts)
    int_counts[-1] += diff
    # Build dict
    for b, c in zip(bitstrings, int_counts):
        if c > 0:
            counts[b] = c
    return counts

mitigated_counts = probs_to_counts(bitstrings, mitigated_probs, shots)
ideal_counts = probs_to_counts(bitstrings, ideal_probs, shots)
Akhir sekali kita melihat taburan mentah, terkurang, dan unggul. "Kiraan" terkurang di bawah hanyalah alat bantu visualisasi yang diperoleh dengan menskala semula kuasi-kebarangkalian terkurang.
from qiskit.visualization import plot_histogram

plot_histogram(
    [raw_counts, mitigated_counts, ideal_counts],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
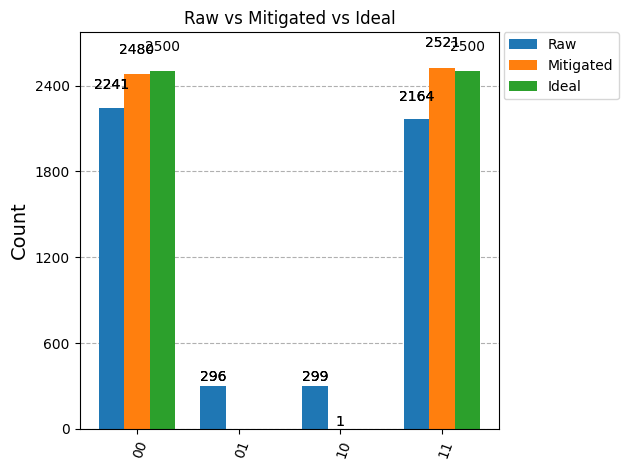
Jelas sekali, keputusan terkurang M3 jauh lebih dekat dengan taburan unggul, dan kita dapat melihat sebabnya.
Menggunakan M3 pada aliran kerja yang lebih realistik adalah jauh lebih kompleks. Pertimbangkan:
- Komputer kuantum sebenar mengandungi banyak qubit fizikal, masing-masing dengan ciri ralat bacaannya sendiri. Ralat ini mesti dimodelkan dan digabungkan dengan sewajarnya.
- Matriks penugasan penuh membesar secara eksponen dengan bilangan qubit dan dengan cepat menjadi tidak praktikal untuk dibina secara eksplisit. Inilah sebabnya M3 menumpukan pada subset hasil yang menyumbang dengan ketara kepada taburan yang diperhatikan dan bukannya membina keseluruhan matriks penugasan.
- Bagi masalah sebenar yang menarik, taburan unggul mungkin tidak diketahui.
Atas semua sebab ini, aliran kerja pengurangan penuh dikapsulkan dalam addon Qiskit mthree.
Contoh M3 yang lebih besar
Kita kini menggunakan M3 pada litar yang lebih besar, yang mana penentuan subruang yang relevan secara manual akan menyusahkan, tetapi masih cukup ringkas supaya kita mengetahui taburan unggulnya: keadaan GHZ. Kita mulakan dengan mengimport pakej mthree dan mentakrifkan litar kuantum GHZ.
import numpy as np
from qiskit import QuantumCircuit

# from qiskit_ibm_runtime.fake_provider import FakeCasablancaV2
import mthree

num_qubits = 10

qc = QuantumCircuit(num_qubits)
qc.reset(range(num_qubits))
qc.h(0)
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)
qc.measure_all()
qc.draw("mpl")
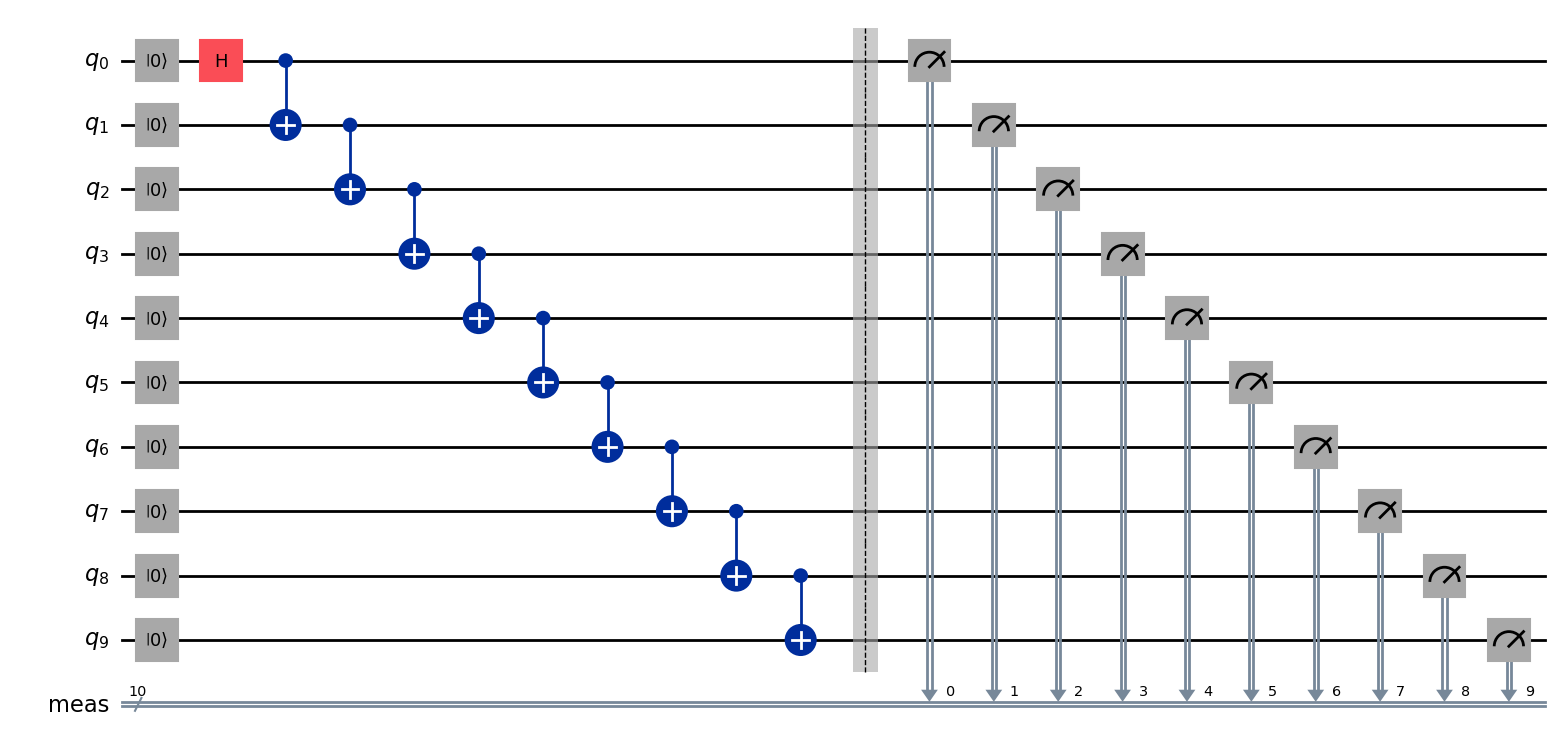
Untuk menjalankan ini pada komputer kuantum sebenar, kita mengimport qiskit_ibm_runtime dan pakej lain yang diperlukan. Kita menggunakan SamplerV2 untuk mendapatkan taburan output.
# Import packages needed for using real quantum computers

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime.executor_sampler import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# --------- Configuration ----------
service = QiskitRuntimeService(channel="ibm_quantum_platform", instance="your crn here")

# backend_real = service.backend("ibm_fez")     # adjust if needed
backend_real = service.least_busy(simulator=False, operational=True)
Sekarang kita mentranspilasi litar ke Backend kita. Kita menetapkan tahap pengoptimuman kepada 0 di sini untuk menumpukan pada kesan M3, tanpa menambah alat tambahan. Ini bermakna fidelity akhir tidak mewakili apa yang boleh dicapai pada perkakasan IBM Quantum® menggunakan set penuh alat yang tersedia, tetapi ia membolehkan kita menumpukan secara khusus pada kegunaan M3.
# Exclude any optimization to focus only on M3 effects
opt_level = 0
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend_real)
qc_isa = pm.run(qc)
Kita kini mengkonfigurasi Sampler, sekali lagi melumpuhkan teknik penindasan ralat tambahan seperti dynamical decoupling dan twirling.
shots = 8192

# No twirling
sampler_no_twirl = Sampler(mode=backend_real)
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = False
sampler_no_twirl.options.default_shots = shots
sampler_no_twirl.options.dynamical_decoupling.enable = False
Akhir sekali, kita melaksanakan job kita.
# This job took 7 seconds on ibm_fez. Your actual execution time can vary.
job = sampler_no_twirl.run([qc_isa])
res_real = job.result()
job_id = job.job_id()
print("job number for real  ", job_id)
job number for real d7ark4e5nvhs73a2fu6g
Kita boleh mengekstrak kiraan mentah daripada litar di atas.
counts_real = []
for i in range(len(res_real)):
    counts_real.append(res_real[i].data.meas.get_counts())
Sekarang kita menjalankan mthree pada Backend kita untuk mencirikan model penugasan yang digunakan untuk pengurangan pengukuran. Kita menskala semula taburan mentah menggunakan maklumat tersebut. Perhatikan bahawa ini kadangkala boleh menghasilkan kebarangkalian negatif yang sangat kecil (maka istilah kuasi-kebarangkalian).
# Added 6 sec on ibm_fez, on top of original 7 sec to run circuits. Your time might differ.
mit_real = mthree.M3Mitigation(backend_real)
mappings_real = mthree.utils.final_measurement_mapping(qc_isa)
mit_real.cals_from_system(mappings_real)
quasis_real = mit_real.apply_correction(counts_real, mappings_real)
Pembetulan mthree menghasilkan kuasi-kebarangkalian, bukan kiraan. Kita boleh menskala semula kepada kiraan secara manual. Fungsi pembantu di bawah menukar kepada kiraan dan membundarkan kepada nilai integer. Selain itu, bagi litar besar, akan terdapat banyak rentetan yang salah dengan kiraan yang sangat sedikit, tetapi yang menyemakkan histogram. Fungsi pembantu kedua di bawah membuang sebarang rentetan dengan kiraan kurang daripada ambang yang kita pilih, supaya kita mendapat pandangan jelas tentang sebutan dominan dalam taburan.
def quasidistribution_to_counts(quasi_list, shots):
    return [
        {bitstr: int(round(float(prob) * shots)) for bitstr, prob in quasi.items()}
        for quasi in quasi_list
    ]

def filter_counts_by_threshold(counts_list, t):
    filtered = []

    for counts in counts_list:
        new_counts = {}
        for bitstr, val in counts.items():
            c = int(round(float(val)))  # FORCE conversion
            if abs(c) >= t:
                new_counts[bitstr] = c
        filtered.append(new_counts)

    return filtered
quasi_counts = quasidistribution_to_counts(quasis_real, shots)
trim_threshold = 30
trimmed_quasi = filter_counts_by_threshold(quasi_counts, trim_threshold)
trimmed_raw = filter_counts_by_threshold(counts_real, trim_threshold)
Kita juga boleh dengan mudah menghasilkan taburan unggul teori yang mempunyai kebarangkalian sama untuk keadaan semua-sifar dan semua-satu, dan kebarangkalian sifar untuk semua hasil lain, sebagai perbandingan.
ideal = [
    {
        "0" * num_qubits: int(round(float(shots) / 2)),
        "1" * num_qubits: int(round(float(shots) / 2)),
    }
]
Akhir sekali, kita boleh memvisualisasikan keputusan kita.
from qiskit.visualization import plot_histogram

plot_histogram(
    [trimmed_raw[0], trimmed_quasi[0], ideal[0]],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
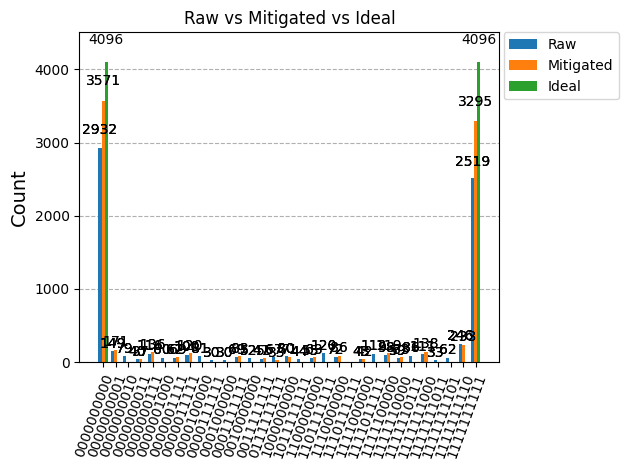
Keputusan terkurang lebih dekat dengan taburan unggul berbanding keputusan tidak terkurang. Kita boleh mengkuantifikasikan ini dengan lebih baik menggunakan kiraan bagi rentetan bit unggul.
def extract_all_zero_and_all_one(counts):
    """
    Extract counts for the all-0 and all-1 bitstrings.

    Parameters
    ----------
    counts : dict[str, int]
        Counts dictionary.

    Returns
    -------
    dict[str, int]
        Dictionary containing only 00...0 and 11...1 entries if present.
    """
    n = len(next(iter(counts)))  # infer bitstring length
    zero_state = "0" * n
    one_state = "1" * n

    return {k: counts[k] for k in (zero_state, one_state) if k in counts}

correct_counts_raw = extract_all_zero_and_all_one(trimmed_raw[0])
correct_counts_mitigated = extract_all_zero_and_all_one(trimmed_quasi[0])
keys = ["0" * num_qubits, "1" * num_qubits]
fidelity_raw = (
    correct_counts_raw.get(keys[0]) + correct_counts_raw.get(keys[1])
) / shots
fidelity_mit = (
    correct_counts_mitigated.get(keys[0]) + correct_counts_mitigated.get(keys[1])
) / shots
print("Percent correct raw counts: ", fidelity_raw)
print("Percent correct mitigated counts: ", fidelity_mit)
Percent correct raw counts:  0.6654052734375
Percent correct mitigated counts:  0.838134765625
Alat ringkas ini meningkatkan fidelity kita sebanyak 26% berbanding fidelity tidak terkurang, dengan overhed yang agak rendah. Jelas bahawa M3 boleh sangat bernilai. Tetapi litar GHZ dipilih sebagai kes penggunaan yang baik, kerana ia sangat memuncak pada dua keadaan output. Sesetengah masalah menghasilkan kiraan yang lebih sekata taburannya (keadaan entropi tinggi). Bagi litar yang sangat dalam dengan banyak qubit, ralat gate dan hingar yang tidak berkaitan dengan ralat pengukuran selalunya akan menghasilkan keadaan entropi tinggi. Dalam kes sedemikian, M3 beroperasi pada ruang keadaan yang agak besar. Terdapat tiga pendekatan yang mungkin untuk ini:
(1) Terima bahawa ini adalah had M3.
(2) Perhatikan bahawa had atas ruang matriks yang dibentuk oleh M3 ialah num_shots num_shots, dan bukannya , dengan yang pertama jauh lebih kecil untuk bilangan qubit yang besar.
(3) Hanya dengan sangat berhati-hati, buang rentetan bit berkebarangkalian sangat rendah daripada kiraan mentah yang dimasukkan ke dalam M3. Ini mungkin memperkenalkan pincang, dan pengehadan sokongan keadaan anda boleh mengganggu penumpuan dalam pendekatan seperti kaedah Krylov. Ini hanya perlu dilakukan apabila anda tahu dengan tepat mengapa anda melakukannya dan dapat menjangka semua kesannya. Itulah sebabnya pemangkasan sedemikian bukan ciri terbina dalam M3.
Untuk maklumat lanjut tentang addon Qiskit mthree, lihat contoh, arahan pemasangan, latar belakang, dan rujukan API dalam dokumentasi nya.
Twirled readout error extinction (TREX)
Twirled Readout Error Extinction (TREX) ialah teknik pengurangan ralat pengukuran yang digunakan pada komputer kuantum moden. Matlamatnya ialah menghapuskan pincang yang diperkenalkan oleh ralat bacaan klasik tanpa memerlukan pencirian penuh atau penyongsangan matriks penugasan pengukuran.
TREX bukan pembetulan ralat dan tidak meningkatkan fidelity keadaan. Sebaliknya, ia memastikan penganggar nilai jangkaan tidak berat sebelah terhadap hingar bacaan, sehingga ralat statistik, dengan mengambil purata ke atas asas pengukuran yang dirawakkan dan menskala semula. Pada perkakasan IBM Quantum, TREX ialah kaedah pengurangan lalai untuk anggaran nilai jangkaan dan sepadan dengan resilience_level = 1 dalam primitif IBM Quantum Estimator.
Sifat ralat bacaan pada perkakasan superkonduktor
Pada qubit superkonduktor IBM, ralat bacaan didominasi oleh:
-
Kebarangkalian pembalikan bit tak simetri (contohnya, lebih kerap daripada sebaliknya)
-
Relaksasi bergantung keadaan semasa pengukuran itu sendiri
-
Gandingan silang yang ringan tetapi tidak boleh diabaikan antara resonator bacaan berjiran
Yang penting, ralat ini selalunya boleh dimodelkan sebagai proses stokastik klasik yang bertindak pada hasil pengukuran. TREX memanfaatkan idea piawai daripada penyesuaian hingar: perawakan (twirling) prosedur pengukuran. TREX lazimnya berjalan dalam dua peringkat:
-
Twirling dan "untwirling" klasik
-
Penskalaan semula nilai jangkaan menggunakan litar penentukuran
Andaikan nilai jangkaan observable berkaitan dengan anggaran berhingar, seperti berikut:
dengan ialah faktor tetap yang menskala anggaran dan ialah pincang daripada sumber yang diterangkan di atas. Kita menggunakan di sini sebagai peringatan bahawa kita hanya menangani ralat bacaan di sini; masih ada ralat gate untuk dipertimbangkan.
Sebelum pengukuran, setiap qubit dikonjugasi secara rawak dengan operator Pauli (seperti I atau X). Hasil pengukuran kemudiannya di-untwirl secara klasik.
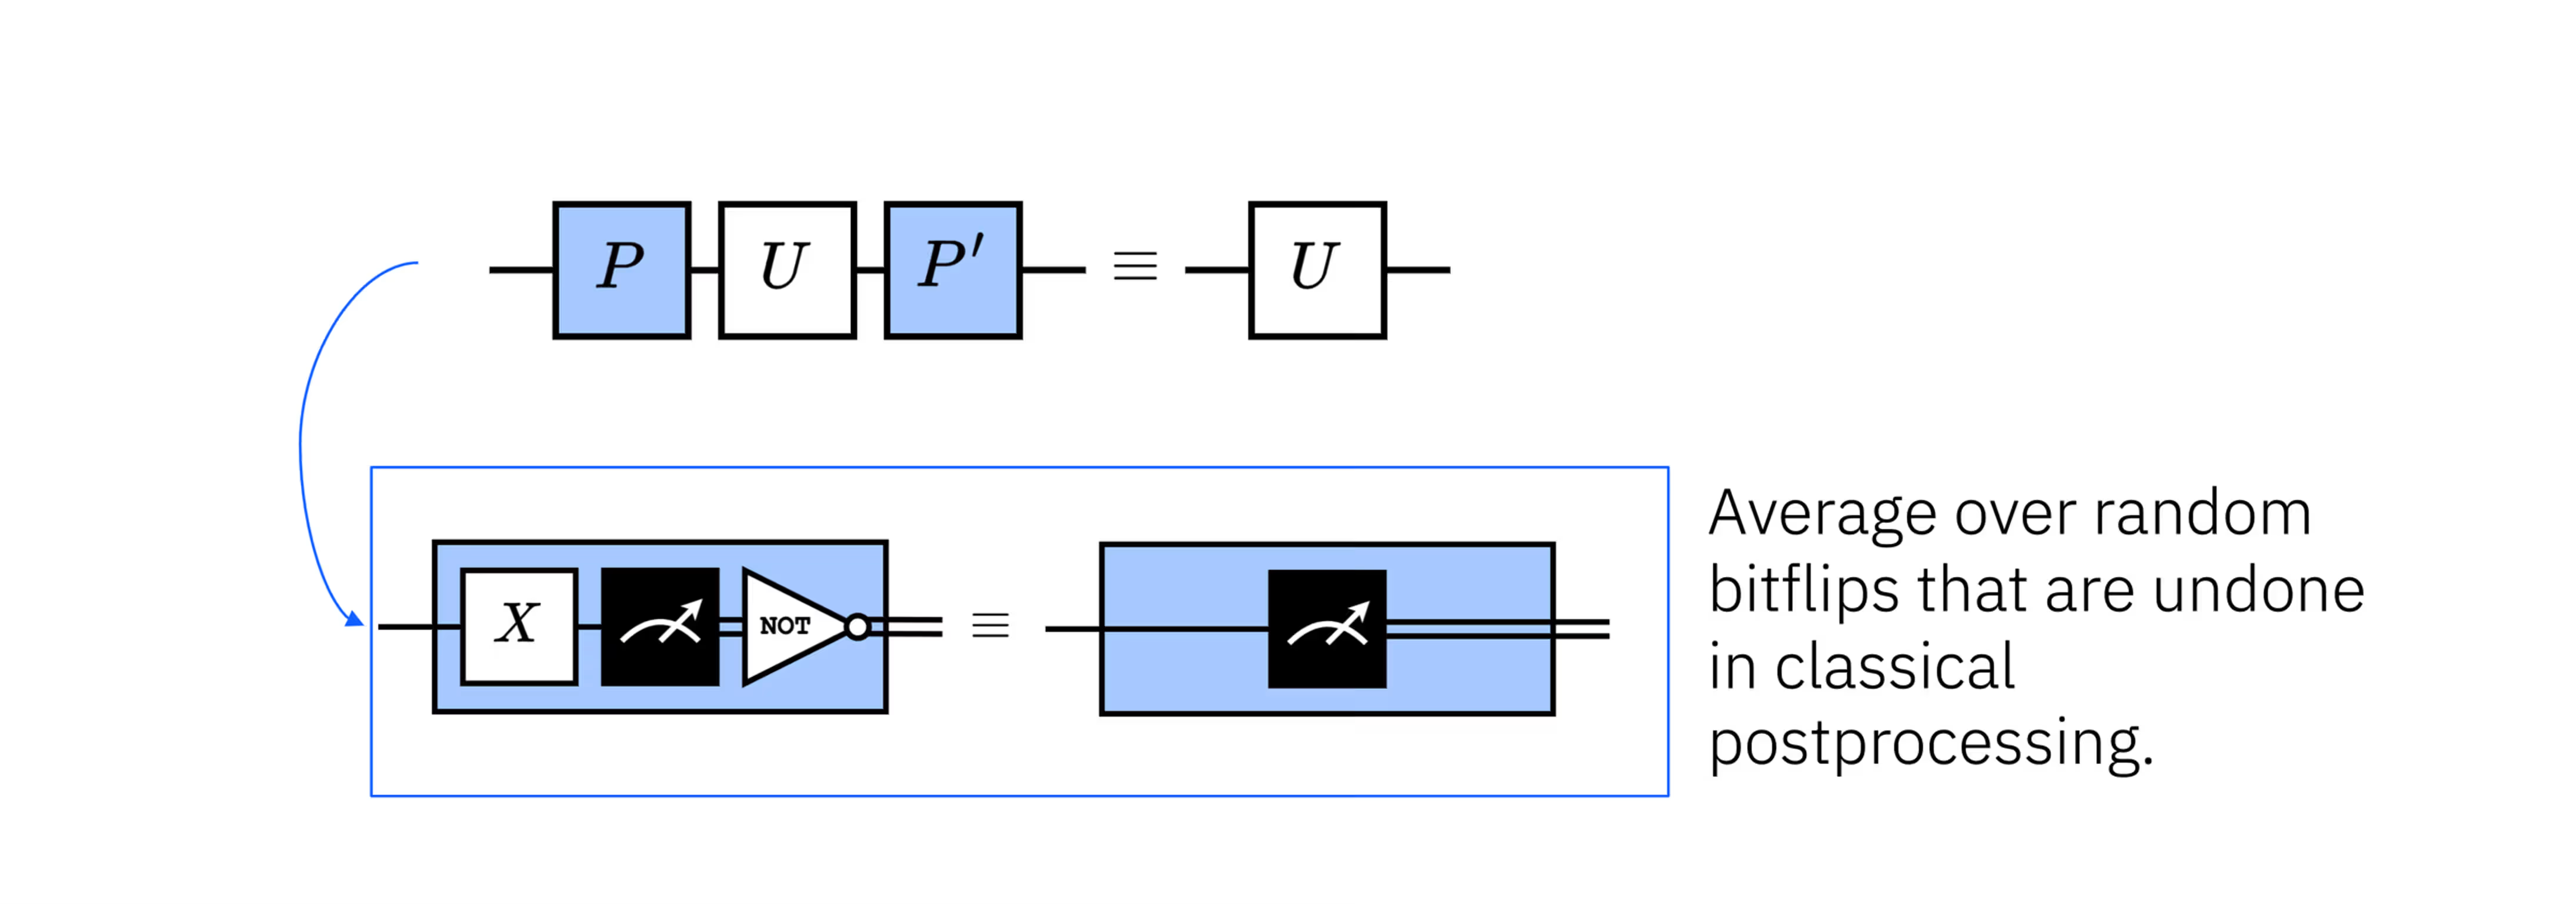
Pengambilan purata ke atas perawakan ini mensimetrikan saluran bacaan. Akibatnya, ketaksimetrian sistematik dalam proses bacaan ditukar kepada saluran ralat yang lebih simetri yang kesan bakinya boleh ditangani melalui penentukuran dan penskalaan semula. Secara mudah, jika sebagai contoh terdapat pincang ke arah keadaan , kita akan kehilangan sebahagian pengukuran . Dengan melakukan twirling di sekitar pengukuran, kita menukar secara rawak hasil logik yang dikaitkan dengan proses bacaan fizikal, kemudian membatalkan pertukaran itu secara klasik selepas itu. Mengambil purata ke atas banyak pengukuran terawak sedemikian menghapuskan keutamaan sistematik bagi satu hasil yang dilaporkan berbanding yang lain. Ini menghapuskan pincang pengukuran dominan di bawah andaian model TREX, supaya kita memperoleh:
Walau bagaimanapun, nilai jangkaan mungkin masih perlu diskala semula. Peringkat kedua ialah menggunakan litar penentukuran (litar dengan hasil yang diketahui) untuk menganggarkan faktor penskalaan . Ini kemudiannya boleh digunakan untuk mendapatkan anggaran yang jauh lebih baik.
Nilai jangkaan observable Pauli menjadi penganggar tidak berat sebelah bagi nilai unggulnya. Tiada model hingar eksplisit yang dipelajari atau disongsangkan, itulah sebabnya TREX stabil secara berangka dan murah. Sekali lagi, ralat gate tidak ditangani di sini.
Dalam penganggaran nilai jangkaan bagi observable , boleh terdapat varians akibat persampelan terhingga, boleh terdapat banyak jenis ralat tak koheren dan koheren, dan boleh juga terdapat pincang, , akibat ralat bacaan. Pincang ini timbul daripada sumber seperti peralihan tak simetri yang telah kita bincangkan. Dalam praktik, pincang ini lazimnya dimodelkan dengan baik sebagai saluran stokastik klasik yang bertindak selepas evolusi kuantum. TREX mengubah saluran pengukuran berkesan supaya penganggar bagi tidak berat sebelah terhadap ralat bacaan. Ini agak mudah dilihat, menggunakan contoh paling ringkas gate twirling: X. Jika terdapat ketaksimetrian dalam berbanding , tetapi kita menukar secara rawak keadaan mana yang dibaca (membalikkannya semula kemudian, secara klasik), maka ini jelas menghapuskan ketaksimetrian sistematik (walaupun persampelan terhingga masih bermakna mungkin terdapat sedikit ketaksimetrian stokastik dalam pengukuran). Dalam praktik, gate twirling untuk TREX tidak terhad kepada I dan X, tetapi ini memadai untuk penerangan.
TREX membolehkan kita memperoleh anggaran nilai jangkaan yang bebas daripada pincang akibat ralat bacaan. Mungkin masih ada pincang daripada sumber lain (seperti putaran berlebihan yang koheren); TREX hanya menyasarkan bacaan. Oleh kerana TREX menggantikan pincang sistematik dengan pensimetrian rawak, ia secara amnya menukar pincang kepada varians stokastik tambahan, meningkatkan varians penganggar pada kos persampelan tetap.
Semak kefahaman anda
Andaikan kita menggunakan Estimator pada litar yang telah menyediakan keadaan dalam penganggaran . Andaikan selanjutnya bahawa ralat pengukuran menyebabkan hasil yang sepadan dengan dilaporkan sebagai sebanyak 10% daripada masa, manakala hasil yang sepadan dengan dilaporkan sebagai hanya 1% daripada masa. Ketaksimetrian antara ralat pelaporan ini memperkenalkan pincang pengukuran.
(a) Tanpa sebarang ralat pengukuran sedemikian, berapakah nilai jangkaan unggul bagi observable ?
(b) Dengan ralat pengukuran atau bacaan tak simetri, berapakah nilai jangkaan bagi observable ?
(c) Pertimbangkan set terhad gate twirling Pauli: I dan X. Andaikan I dan X digunakan secara rawak dengan kebarangkalian 50% dalam berbilang shot. Kadar ralat pengukuran yang sama masih terpakai. Kemudian gate Pauli (I atau X) dibatalkan secara klasik. Buat jadual semua hasil yang mungkin dan kebarangkalian masing-masing disebabkan superposisi awal, ralat pengukuran tak simetri, dan gate Pauli yang ditugaskan secara rawak.
(d) Gunakan jadual itu untuk menentukan nilai jangkaan menggunakan strategi twirling.
(e) Bandingkan nilai jangkaan: unggul, tanpa twirling, dan dengan twirling.
(f) Apakah yang telah ditinggalkan daripada rawatan ini yang terdapat dalam aplikasi TREX penuh?
Jawapan
(a) Anda boleh menggunakan intuisi dan simetri untuk mengatakan . Untuk menunjukkan secara eksplisit:
(b) Keadaan boleh runtuh kepada atau apabila diukur, masing-masing dengan peluang 50%. Tetapi daripada 50% yang runtuh kepada keadaan , 1% daripadanya (atau 0.5% daripada semua kes) akan tersalah dilaporkan sebagai . Daripada 50% yang runtuh kepada , 10% (atau 5% daripada semua kes) akan tersalah dilaporkan sebagai . Ini meninggalkan kita dengan:
- 54.5%
- 45.5% Tanpa mengambil kira semua jenis ralat lain yang mungkin, kita akan memperoleh anggaran
(c)
| Pauli | Hasil pengukuran unggul | Hasil selepas Pauli | Ralat bacaan | Batalkan Pauli | Hasil akhir dilaporkan | Kebarangkalian |
|---|---|---|---|---|---|---|
| I | 0 | 0 | Tiada | I | 0 | 50% 50% 99% = 24.75% |
| I | 0 | 0 | I | 1 | 50% 50% 1% = 0.25% | |
| I | 1 | 1 | Tiada | I | 1 | 50% 50% 90% = 22.5% |
| I | 1 | 1 | I | 0 | 50% 50% 10% = 2.5% | |
| X | 0 | 1 | Tiada | X | 0 | 50% 50% 90% = 22.5% |
| X | 0 | 1 | X | 1 | 50% 50% 10% = 2.5% | |
| X | 1 | 0 | Tiada | X | 1 | 50% 50% 99% = 24.75% |
| X | 1 | 0 | X | 0 | 50% 50% 1% = 0.25% |
(d) Daripada bahagian sebelumnya, kita tahu nilai jangkaan Z dalam setiap keadaan akhir. Kita hanya perlu mengambil purata berpemberat:
(e) Dalam kes yang sangat ringkas ini, penggunaan twirling kita memulihkan dengan tepat nilai jangkaan unggul. Itu bukan perkara lazim. Yang lazim ialah twirling membatalkan pincang seperti yang diperkenalkan melalui peralihan tak simetri, dan mengembalikan nilai jangkaan yang lebih dekat dengan nilai unggul.
(f) Ini ialah aplikasi model mainan. Mungkin ada beberapa perkara yang tiada. Terutamanya, kita tidak menjalankan litar penentukuran di sini untuk menganggarkan faktor penskalaan semula . Ini lazimnya diperlukan.
Butiran pelaksanaan
TREX digunakan secara automatik apabila menggunakan primitif EstimatorV2 dengan resilience_level = 1 (lalai). Perhatikan bahawa ia tidak digunakan secara automatik pada primitif Sampler, kerana Sampler mengembalikan taburan kebarangkalian penuh dan bukannya nilai jangkaan.
Apabila TREX didayakan, runtime menjana varian litar terpilin-pengukuran dengan menyisipkan Pauli satu-qubit rawak sejurus sebelum pengukuran. Pasca-pemprosesan klasik membalikkan Pauli ini. Varian litar ini adalah rawak merentasi shot yang berbeza dan juga merentasi qubit yang berbeza dalam satu shot. Semua varian litar kemudiannya digabungkan menjadi satu penganggar.
TREX sangat berskala. Ia memerlukan litar penentukuran tambahan, sehingga overhed persampelan lazimnya faktor tetap yang kecil (selalunya 2-4x). Tetapi pengurangan itu khusus observable, bukan mengekalkan taburan.
TREX direka untuk disepadukan dengan baik bersama banyak kaedah penindasan ralat dan pengurangan ralat, termasuk yang berikut:
-
Dynamical decoupling (DD) - bertindak semasa masa melahu, ortogon kepada pengurangan bacaan.
-
Gate atau Pauli twirling - selalunya saling melengkapi; TREX sudah bergantung pada twirling tetapi hanya menyasarkan hingar bacaan.
-
Zero-Noise Extrapolation (ZNE) - ZNE menyasarkan hingar gate, manakala TREX menangani pincang pengukuran. Gabungan ini digunakan pada tahap daya tahan 2.
-
Penguatan ralat probabilistik dan pembatalan ralat probabilistik dalam aliran kerja Estimator.
Walau bagaimanapun, sesetengah kaedah tidak boleh (atau tidak sepatutnya) digabungkan dengan TREX:
-
Pembetulan kebarangkalian peringkat Sampler: TREX tidak mengembalikan kebarangkalian rentetan bit yang dibetulkan.
-
Pengurangan post-hoc pada data TREX yang sudah dikurangkan: pembetulan berganda boleh memperkenalkan semula pincang.
Menggabungkan TREX dengan pengurangan bacaan berasaskan matriks penugasan seperti M3 adalah rumit. M3 mengandaikan saluran pengukuran yang tetap. TREX sengaja merawakkan pengukuran, sekali gus membatalkan andaian yang digunakan oleh M3. Dalam erti kata itu, anda tidak boleh sekadar menggabungkan teknik-teknik ini. Namun, jika anda menggunakan twirling pengukuran semasa penentukuran yang digunakan dalam M3, anda mungkin dapat memanfaatkan pendekatan seakan-akan matriks penugasan dan pendekatan pengurangan twirling secara serentak (walaupun pendekatan twirling ini tidak sama sepenuhnya dengan TREX). Ini ialah tema yang berulang dalam menggabungkan teknik pengurangan dan penindasan: menambah teknik secara membuta tuli akan gagal; menambahnya dengan teliti supaya teknik-teknik itu "sedar" akan satu sama lain boleh berjaya dan amat bermanfaat.
TREX hanya menjamin nilai jangkaan yang bebas daripada pincang akibat ralat bacaan; ia tidak mengurangkan varians, dan tidak melindungi daripada jenis pincang lain. Ia sudah tentu tidak membetulkan semua ralat. Namun, ia sering merupakan peningkatan yang ketara, dan boleh dicapai dengan overhed yang jauh lebih rendah daripada beberapa kaedah lain yang memerlukan pembelajaran model hingar penuh. TREX selalunya pengurangan bacaan yang paling murah dan paling teguh yang tersedia, menjadikannya lalai yang sangat baik dalam eksperimen.
TREX dengan Qiskit
Di sini kita mencipta litar dua qubit yang ringkas, dan menggunakan Estimator untuk menganggarkan nilai jangkaan bagi satu observabel yang sangat ringkas, ZX. Nilai jangkaan unggul ialah 1. Kita akan membandingkan nilai jangkaan dengan dan tanpa TREX.
# Import packages needed for using real quantum computers

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Session
import numpy as np

# --------- Configuration ----------

backend = service.backend("ibm_fez")  # adjust if needed
Cipta litar kuantum yang ringkas.
qc = QuantumCircuit(2)
qc.x(0)
qc.h(0)
qc.cx(0, 1)
qc.h(0)
qc.barrier()
qc.draw("mpl")

Transpile litar menggunakan pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend)

qc_t = pass_manager.run(qc)
Gunakan susun atur yang sama daripada transpilation pada observabel.
# Observable: X on qubit 0, Z on qubit 1, ideal expectation value is 1.0.
observable = SparsePauliOp("ZX")
observable_t = observable.apply_layout(qc_t.layout)
Jalankan eksperimen pada komputer kuantum sebenar. Mula-mula kita teruskan dengan reslience_level = 1; ini ialah nilai lalai, tetapi kita menyatakannya secara eksplisit untuk membezakan kedua-dua kes.
# First, we run this on an ideal simulator to confirm the ideal expectation value.

from qiskit.primitives import StatevectorEstimator as Estimator

estimator = Estimator()

job = estimator.run(pubs=[(qc, observable)])

res = job.result()
val = res[0].data.evs

print("⟨ZX⟩ ideal:", val)
⟨Z₀⟩ ideal: 0.9999999999999996
# This took 27 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ with TREX:", val)
⟨Z₀⟩ with TREX: 0.9520029143897996
Sekarang kita tetapkan resilience_level kepada 0 untuk menjalankan tanpa TREX.
# This took 12 sec on ibm_fez. Your runtime might differ.
with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ without TREX:", val)
⟨Z₀⟩ without TREX: 0.8651
Nilai jangkaan jauh lebih hampir dengan nilai unggul (1) dengan TREX, seperti yang dijangkakan. Tentu sekali, ini ialah satu nilai jangkaan pada satu qubit. Sekarang kita menyediakan litar menggunakan get bukan Clifford dan banyak qubit untuk menguji sama ada peningkatan TREX kekal teguh dalam keadaan yang berbeza.
import numpy as np

num_qubits = 20
qc = QuantumCircuit(num_qubits)
for i in range(num_qubits):
    qc.rx(np.pi * 7 / 8, i)
qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=20, num_clbits=0, params=[]), qubits=(<Qubit register=(20, "q"), index=0>, <Qubit register=(20, "q"), index=1>, <Qubit register=(20, "q"), index=2>, <Qubit register=(20, "q"), index=3>, <Qubit register=(20, "q"), index=4>, <Qubit register=(20, "q"), index=5>, <Qubit register=(20, "q"), index=6>, <Qubit register=(20, "q"), index=7>, <Qubit register=(20, "q"), index=8>, <Qubit register=(20, "q"), index=9>, <Qubit register=(20, "q"), index=10>, <Qubit register=(20, "q"), index=11>, <Qubit register=(20, "q"), index=12>, <Qubit register=(20, "q"), index=13>, <Qubit register=(20, "q"), index=14>, <Qubit register=(20, "q"), index=15>, <Qubit register=(20, "q"), index=16>, <Qubit register=(20, "q"), index=17>, <Qubit register=(20, "q"), index=18>, <Qubit register=(20, "q"), index=19>), clbits=())
Di sini, tiada apa-apa yang istimewa tentang sudut putaran . Kita sekadar memilih mana-mana superposisi tidak sama rata bagi dan untuk mengkaji kesan peralihan ralat tidak simetri dan cara ia dikendalikan oleh TREX. Dengan keadaan ini, nilai jangkaan unggul bagi Z pada setiap qubit, tanpa sebarang ralat (bacaan atau lain-lain) ialah:
Oleh itu, kita berharap memperoleh nilai jangkaan yang hampir dengan -0.924 pada semua qubit. Kita akan lihat sama ada TREX memperbaiki setiap nilai jangkaan secara individu dan juga sama ada ia memperbaiki purata bagi semua qubit.
Semak kefahaman anda
Sahkan nilai jangkaan di atas melalui pengiraan langsung.
Jawapan
Kita melakukan transpile menggunakan pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend_real)

qc_t = pass_manager.run(qc)
Sekarang kita membina satu observabel bagi setiap qubit supaya kita dapat menganggarkan kesemua dua puluh nilai jangkaan dalam satu aliran kerja. Maksudnya, bagi qubit ke-, kita mahu observabel dengan semua identiti , kecuali pada kedudukan ke-, di mana kita mahu . Ingat untuk menggunakan susun atur hasil transpile anda pada observabel anda juga.
# Observables: Z on qubit i for all i.
observables = []
for i in range(num_qubits):
    obs_string = "I" * i + "Z" + "I" * (num_qubits - i - 1)
    obs = SparsePauliOp(obs_string)
    observables.append(obs)
observables_t = [obs.apply_layout(qc_t.layout) for obs in observables]
Sekarang kita boleh melaksanakan. Sel kod di bawah menggunakan session mode; jika anda tidak mempunyai akses kepada session, anda boleh menggantikannya dengan batch mode untuk menjalankan aliran kerja yang sama tetapi dengan kemungkinan masa giliran antara litar.
# This took 20 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX turned off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_no_trex = job.result()
    val_no_trex = res_no_trex[0].data.evs

print("⟨Z_i⟩ without TREX:", val_no_trex)
⟨Z_i⟩ without TREX: [-0.90645 -0.89755 -0.89125 -0.9165  -0.87655 -0.91035 -0.8757  -0.87905
 -0.66035 -0.8876  -0.87125 -0.89975 -0.83745 -0.89755 -0.82645 -0.90325
 -0.84385 -0.90195 -0.85865 -0.8884 ]
# This took 36 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_trex = job.result()
    val_trex = res_trex[0].data.evs

print("⟨Z_i⟩ with TREX:", val_trex)
⟨Z_i⟩ with TREX: [-0.92086303 -0.90253698 -0.91688854 -0.93308327 -0.91273953 -0.9221892
 -0.903782   -0.93046052 -0.90348934 -0.90284174 -0.89499677 -0.91630959
 -0.89508481 -0.92233292 -0.90497141 -0.91867138 -0.91421506 -0.91646851
 -0.9268364  -0.91669818]
Di sini kita membandingkan ralat mutlak purata dengan dan tanpa TREX.
ideal = np.cos(7 * np.pi / 8)

mean_abs_error_no_trex = np.mean(np.abs(val_no_trex - ideal))
mean_abs_error_trex = np.mean(np.abs(val_trex - ideal))

print("The mean absolute error without TREX is: ", mean_abs_error_no_trex)
print("The mean absolute error with TREX is: ", mean_abs_error_trex)
The mean absolute error without TREX is:  0.05238453251128674
The mean absolute error with TREX is:  0.011980732757900719
zx = list(range(num_qubits))
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(zx, val_no_trex, c="blue", linestyle="-", label="No TREX", alpha=0.7)

## Add values with DD
ax.scatter(zx, val_trex, c="red", linestyle="-", label="With TREX", alpha=0.7)

# Add ideal reference line
ax.axhline(y=-0.924, color="black", linestyle="--", linewidth=2, label="Ideal ⟨Z⟩")

# Add labels and plot
ax.set_xlabel("Qubits")
ax.set_ylabel("<Z>")
ax.legend()
ax.set_title("<Z> in RX(7pi/8)|0> state with and without TREX")
ax.grid(True)

plt.show()
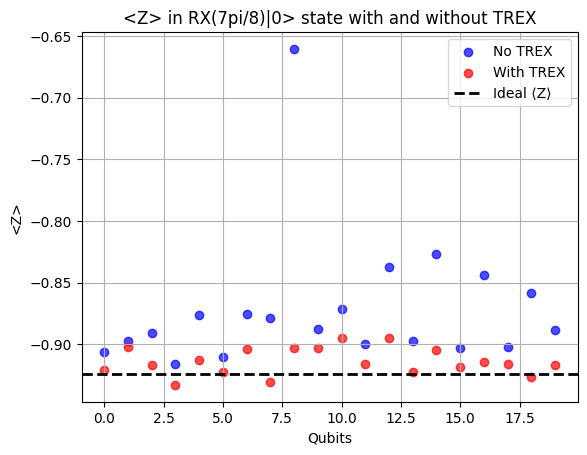
TREX nyata telah membantu. Nilai jangkaan pada setiap qubit telah bertambah baik, kecuali qubit 16. Nilai terpencil sedemikian memang dijangka. Kita boleh mengukur kesan keseluruhan TREX pada litar dengan mengambil nilai purata.
mean_no_trex = sum(val_no_trex) / num_qubits
mean_trex = sum(val_trex) / num_qubits

print("Mean without TREX", mean_no_trex)
print("Mean with TREX", mean_trex)
Mean without TREX -0.8714950000000001
Mean with TREX -0.9137729590315635
Secara purata, TREX menggerakkan keputusan kita kira-kira 2.9% lebih dekat dengan keputusan unggul, dan meninggalkan kita dengan keputusan yang, secara purata, berbeza daripada nilai unggul teori hanya 0.4%. Ini bagus, dan peningkatan beroverhed rendah inilah sebabnya TREX ialah pengurangan ralat lalai pada Estimator. Namun kita sekali lagi mesti menekankan bahawa TREX menghapuskan pincang dalam ralat bacaan, bukan membetulkan semua ralat kita. Kita memilih keadaan awal yang berkemungkinan besar terjejas oleh asimetri dalam bacaan. Kesannya akan berbeza jika kita menyediakan setiap qubit dalam keadaan yang berlainan. Sebagai hujah mudah mengapa ini mesti benar, pertimbangkan apa yang akan berlaku jika kita membiarkan setiap qubit dalam keadaan asas . Tiada peluang untuk memerhati (atau membetulkan) asimetri dalam ralat bacaan antara keadaan dan .
Ekstrapolasi hingar sifar (ZNE)
Ekstrapolasi hingar sifar (ZNE) ialah salah satu teknik pengurangan ralat yang paling meluas digunakan. Strategi amnya juga mudah difahami, walaupun butiran pelaksanaannya kompleks. ZNE berfungsi dengan:
-
Menjalankan litar sasaran pada beberapa "tahap hingar" — pengubahsuaian pada litar yang menyebabkan hingarnya berskala dengan cara yang boleh diramal
-
Menganggarkan observabel yang diminati bagi setiap skala hingar.
-
Mengekstrapolasi kembali kepada hingar sifar menggunakan model penyuaian (linear, polinomial, eksponen, dan sebagainya).
Hasilnya ialah anggaran tentang nilai observabel itu dalam had hingar sifar yang tersirat oleh model ekstrapolasi.
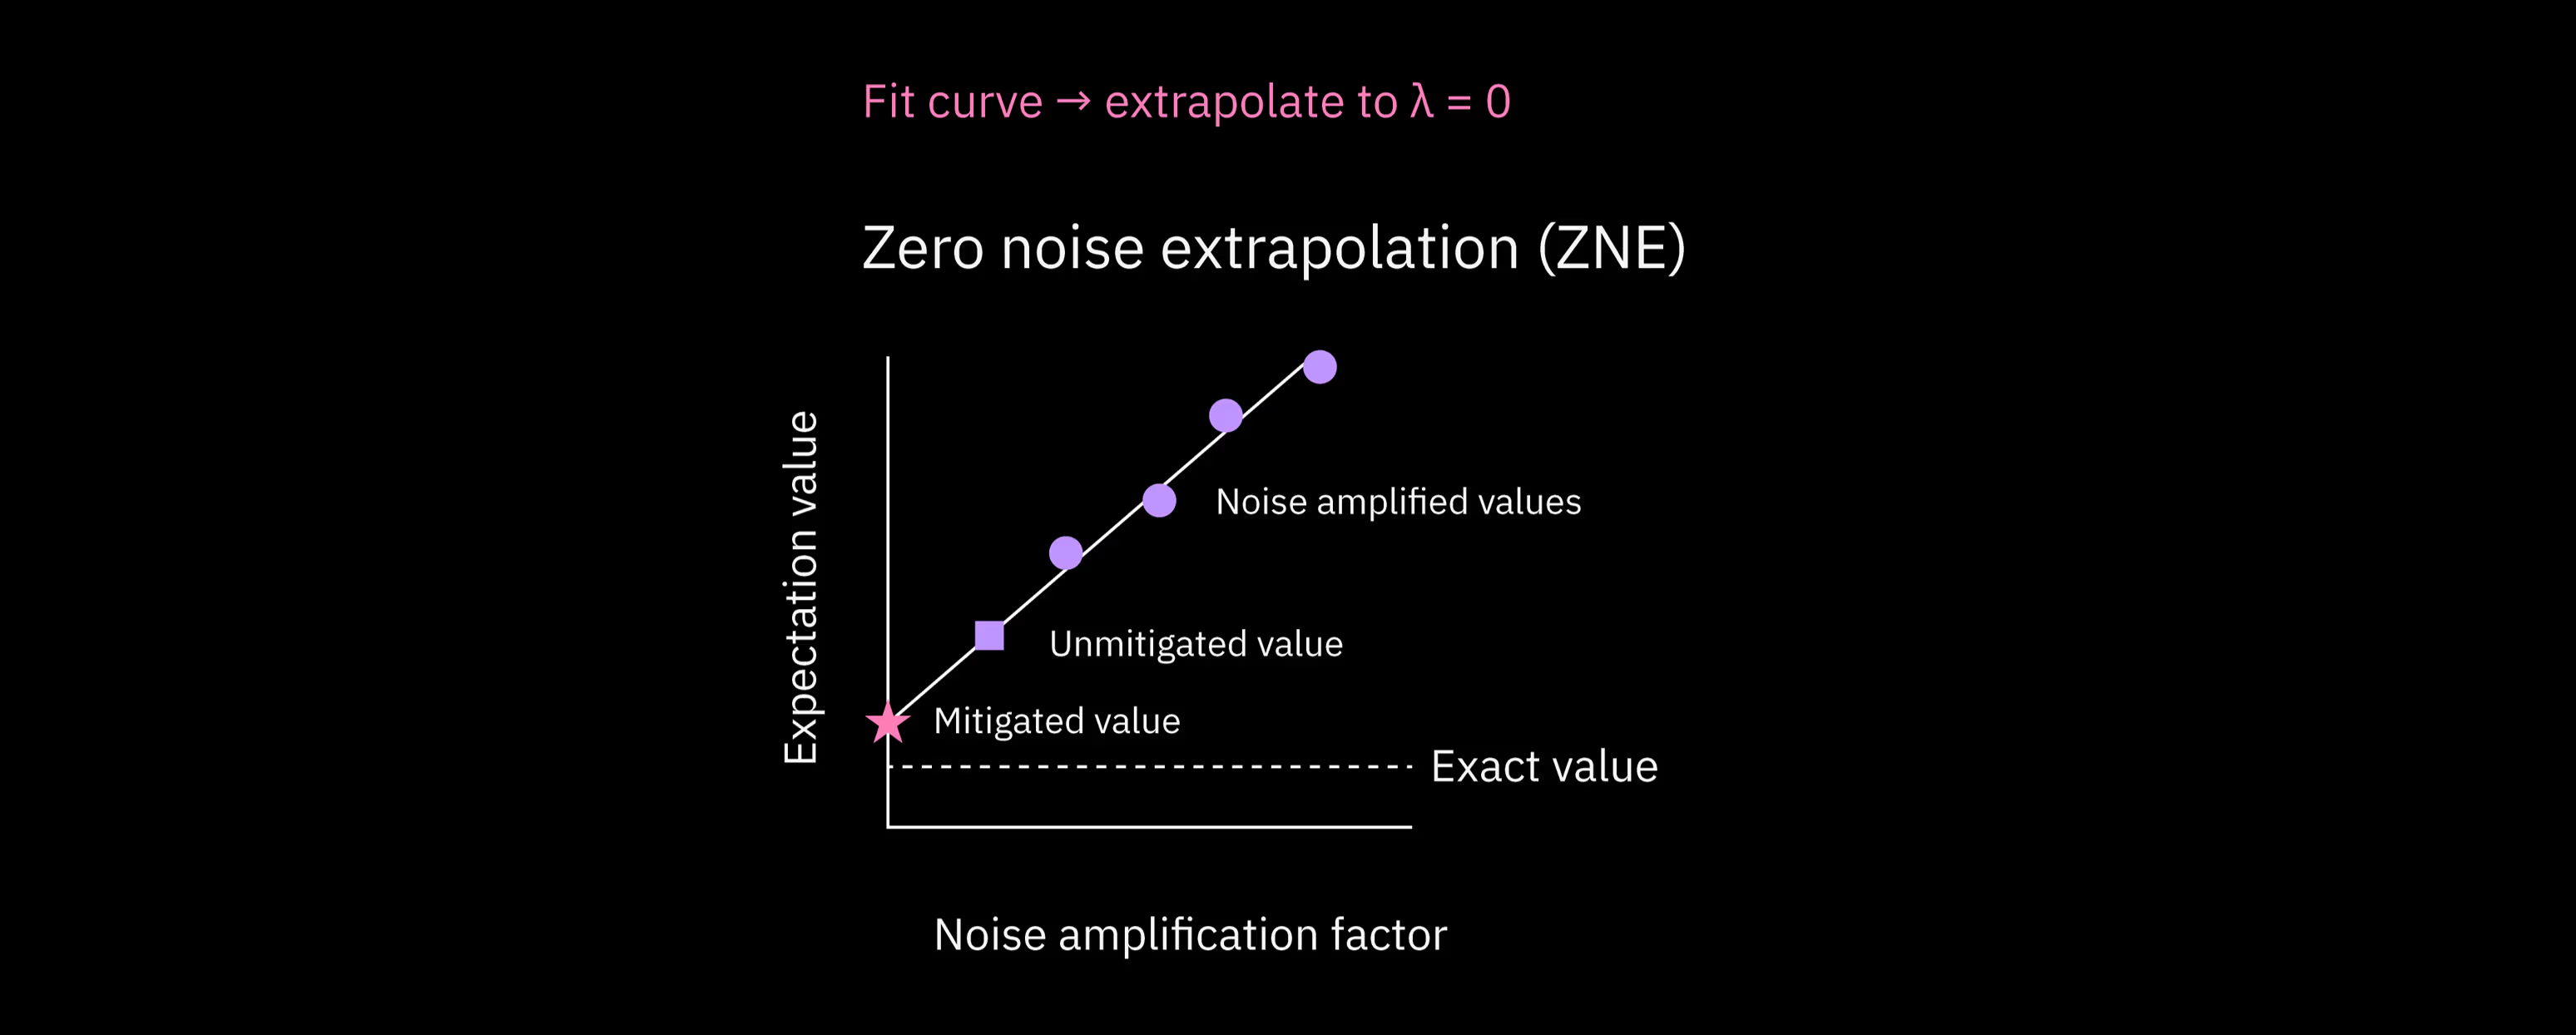
ZNE tidak menjamin bahawa hingar meningkat secara lancar atau linear apabila kita mengubah suai litar. Sebaliknya, ia mengandaikan bahawa penskalaan hingar berkelakuan cukup baik untuk membenarkan ekstrapolasi. Kerumitan dalam ZNE terletak pada cara seseorang mengubah suai litar untuk memenuhi andaian ini sebaik mungkin. Kita akan meneliti beberapa pendekatan dalam pelajaran ini.
Penskalaan sumber ZNE
Dalam ZNE, overhed kebanyakannya ialah overhed kuantum. Maksudnya, untuk memperoleh nilai jangkaan pada tahap hingar, anda perlu menjalankan eksperimen anda pada litar, masing-masing dengan banyak shot. Untuk mengekalkan ketepatan statistik yang tetap, jumlah sampel secara amnya meningkat apabila litar berskala hingar tambahan diperkenalkan.
Bilangan tahap hingar yang anda kaji, , bergantung pada kaedah yang digunakan untuk menskalakan hingar. Bagi satu teknik penskalaan hingar yang ringkas (dipanggil "gate-folding", dibincangkan di bawah), lazimnya antara 3 dan 5. Kaedah yang berbeza (penguatan hingar kebarangkalian (PNA)) membenarkan faktor hingar bukan integer, dan lazimnya menghasilkan tahap hingar yang lebih rendah daripada gate-folding. Jumlah overhed berskala kira-kira sebagai:
di mana ialah bilangan shot asas. Satu lagi perkara yang perlu diingat ialah jika penskalaan hingar melibatkan get yang diulang, kedalaman litar mungkin meningkat dengan faktor yang berkadar dengan nilai penskalaan hingar. Penskalaan hingar yang datang bersama pertambahan kedalaman memang menjadi tujuannya, tetapi ingat jumlah kedalaman.
ZNE sesuai untuk masalah di mana perkara berikut terpakai:
-
Anda memerlukan kaedah pengurangan serba guna yang berkesan pada banyak jenis ralat.
-
Kedalaman litar tidak terlalu besar; ZNE gagal apabila litar berskala menjadi terlalu bising untuk diekstrapolasi.
-
Anda boleh menerima overhed masa jalan yang sederhana demi ketepatan yang lebih baik.
Dalam praktik, ini menjadikan ZNE sesuai untuk banyak litar variasi, penganggaran nilai jangkaan, dan algoritma kuantum jangka dekat yang lain. Ia dilaksanakan dalam Estimator menggunakan resilience_level = 2. Perhatikan bahawa ZNE mengekstrapolasi dalam ruang yang mempunyai satu hasil tunggal sebagai fungsi hingar di seluruh litar. Ini bermakna ia sesuai untuk masalah penganggaran, tetapi tidak untuk masalah persampelan. Ia tidak direka untuk berfungsi pada taburan rentetan bit.
Faktor hingar
Bagaimanakah sebenarnya kita boleh meningkatkan tahap hingar dalam litar? Terdapat dua cara utama, walaupun banyak variasi wujud.
-
Gantikan get atau blok get dengan . Oleh kerana get pada komputer kuantum adalah uniter, kita tahu bahawa supaya secara logik: . Namun, setiap pengulangan atau menambah ralat yang serupa atau sama, membolehkan kita menaikkan tahap hingar/ralat. Perhatikan bahawa penggantian yang ditunjukkan di atas membawa kita daripada hingar asal get (tahap hingar 1) kepada tiga kali ganda tahap hingar itu dalam (tahap hingar 3). Dalam praktik, kita boleh mengulang dua get terakhir sebanyak kali: untuk memperoleh tahap hingar . Ini dipanggil gate folding, dan ia ialah teknik penskalaan hingar yang sangat lazim.
-
Terdapat kaedah lain untuk meningkatkan tahap hingar, seperti penguatan ralat kebarangkalian (PEA). Dalam PEA, kita mula-mula mempelajari model hingar yang sesuai untuk litar, lazimnya dinyatakan sebagai saluran Pauli. Hingar kemudian dikuatkan dengan membuat persampelan daripada versi saluran hingar yang telah dipelajari ini yang diskalakan semula. Dengan melaraskan persampelan, anda boleh menskalakan kekuatan hingar berkesan secara berterusan, termasuk kepada nilai bukan integer.
Dalam praktik, gate folding boleh menskalakan ralat dengan sangat boleh dipercayai, tetapi ia juga boleh menghasilkan litar yang sangat dalam. Jika anda hanya memerlukan tiga tahap hingar (1, 3, dan 5), ini bermakna meningkatkan kedalaman litar anda dengan faktor 5 dan masih memperoleh keputusan yang munasabah. Oleh itu, jika litar sasaran anda mempunyai kedalaman dua qubit hasil transpile sebanyak 60 atau lebih, PEA berkemungkinan lebih sesuai daripada gate-folding.
Get boleh dilipat sama ada secara setempat (bermaksud anda mengulang bagi setiap get dua qubit sebaik sahaja ia berlaku), atau ia boleh dikumpulkan menjadi blok get dan blok itu diulang (seperti get ). Lipatan setempat sering lebih baik bagi andaian yang dibuat oleh ZNE, tetapi kedua-duanya boleh dilakukan.
Banyak nuansa terlibat dalam rawatan statistik keputusan berskala hingar dalam ZNE. Contohnya, pada lima kali ganda tahap hingar, keputusan anda pasti mempunyai varians yang lebih tinggi dan kurang boleh dipercayai. Patutkah ia diberi pemberat yang sama seperti titik data berhingar rendah? Tidak. Namun, bagi tujuan melihat ZNE berfungsi, kita akan mengabaikan sebahagian kerumitan ini untuk eksperimen model mainan, di mana kita akan membina litar terlipat secara manual, dan melakukan ekstrapolasi naif dengan pemberat sama rata untuk menggambarkan langkah-langkah utama. Tetapi kita akan menyusulinya dengan eksperimen menggunakan fungsi ZNE terbina dalam Qiskit, dan kita akan melihat bahawa ia mengendalikan kerumitan yang kita langkau dengan jauh lebih baik.
ZNE secara manual
Kita bermula dengan memilih litar kuantum dan observable yang nilai jangkaan unggulnya boleh dikira tanpa hingar dan ralat. Kita memilih keadaan GHZ , dengan bilangan qubit genap. Observable kita ialah . Kita memilih ini atas beberapa sebab:
- Nilai jangkaan mudah dikira dalam kes unggul. Oleh kerana bilangan qubit genap, kita mendapat
1daripada setiap , didarab bersama, atau kita mendapat-1daripada setiap , didarab bersama sebanyak bilangan genap kali. - Ini agak sensitif kepada ralat dan hingar, kerana satu ralat pada satu qubit boleh membalikkan hasil keseluruhan shot itu daripada +1 kepada -1.
- Nilai jangkaan jauh daripada 0. ZNE boleh menghadapi kesukaran apabila nilai jangkaan unggul sangat hampir kepada sifar, kerana tahap hingar yang tinggi cenderung merawakkan hasil, menjadikannya positif sama kerap dengan negatif. Akibatnya, nilai hingar yang tinggi akan menghasilkan nilai yang hampir dengan nilai unggul; ini boleh menjadikan ekstrapolasi sangat rumit.
Dengan motivasi ini dalam fikiran, mari kita bina litar kita.
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
num_qubits = 10  # must be even

# # Noise amplification factors used for folding (2* integer +1 for gate folding)
noise_steps = [1, 3, 5]
ghz_amp = []

for j in noise_steps:
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    # Since CX^2 = I, odd repetitions implement folded versions of the gate.
    for i in range(num_qubits - 1):
        for gates in range(j):
            qc.cx(i, i + 1)
    qc.barrier()
    ghz_amp.append(qc)
Perhatikan kehalusan bahawa di sini . Walaupun gate folding diperkenalkan sebagai terdiri daripada operator berbentuk , di sini struktur yang sama kelihatan seperti CNOT CNOT CNOT.
Mari kita pastikan litar ke- kita memang litar GHZ biasa:
ghz_amp[0].draw("mpl")
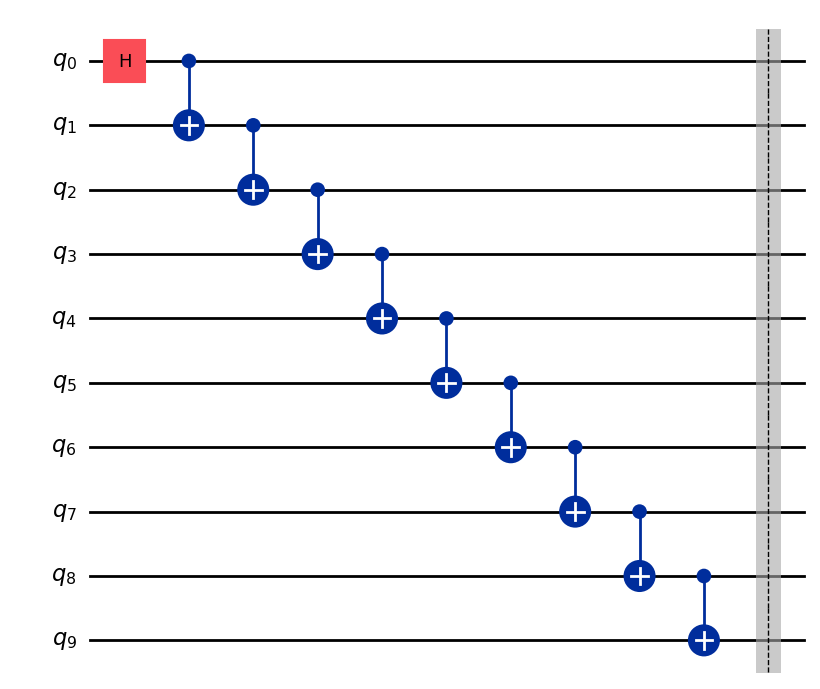
Anda boleh melihat litar-litar lain untuk mengesahkan bahawa ia mempunyai struktur yang dijangka.
Sekarang kita membina observabel kita.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
observables = []
for j in range(len(noise_steps)):
    observables.append(observable)
Kita membina pass manager dan menggunakannya pada litar kita. Kemudian kita mengambil susun atur dan menggunakannya pada observabel kita.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=0,
)

qcs_transpiled = []
obs_transpiled = []

for j in range(len(ghz_amp)):
    # Transpile the circuit
    qc_pm = pm.run(ghz_amp[j])
    qcs_transpiled.append(qc_pm)
    # Extract the final layout
    layout = qc_pm.layout
    # Apply the layout to the observable
    obs_transpiled.append(observable.apply_layout(layout))
Format pubs.
pubs = [(qc, obs) for qc, obs in zip(qcs_transpiled, obs_transpiled)]
Sekarang kita menjalankan Estimator. Kita ingin menumpukan pada peranan ZNE, jadi kita mungkin mahu menetapkan resilience_level = 0 untuk mengelakkan kesan twirling bercampur dengan kesan ZNE. Namun, kita juga mahu membandingkan ZNE "secara manual" kita dengan tetapan ZNE terbina dalam Qiskit, yang termasuk twirling. Oleh itu kita menetapkan resilience_level = 1 di sini. Menetapkan resilience_level = 2 mengaktifkan tetapan ZNE Qiskit, yang akan kita gunakan sebentar lagi.
# This took 21 sec on ibm_fez. Your actual runtime might vary.
options = EstimatorOptions(resilience_level=1)

estimator = Estimator(
    mode=backend_real,
    options=options,
)

job = estimator.run(pubs)

res = job.result()
Sekarang kita mencetak tahap hingar dan nilai jangkaan.
# We save this for later comparisons
value_no_zne = res[0].data.evs

# Print all values used for extrapolation
print("Noise level 1: ", res[0].data.evs)
print("Noise level 3: ", res[1].data.evs)
print("Noise level 5: ", res[2].data.evs)
Noise level 1:  0.8327970939283861
Noise level 3:  0.5612869745718734
Noise level 5:  0.3130254281266217
Inilah bahagian di mana kita paling ambil mudah: kita melakukan penyuaian linear pada data ini tanpa memberi perhatian kepada varians setiap nilai yang kita peroleh, dan tanpa cuba meramal secara teori sama ada penyuaian itu perlu linear. Sekali lagi, ZNE terbina dalam melakukan kerja yang jauh lebih baik daripada apa yang kita lakukan secara manual.
# Data
noise_factors = np.array([1, 3, 5])
values = np.array([res[0].data.evs, res[1].data.evs, res[2].data.evs])

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.12994291645044112
Zero-noise extrapolated value: 0.9588652482269501
Kita teruskan dengan memplot ini sebelum membuat tafsiran.
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Zero-noise estimate")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
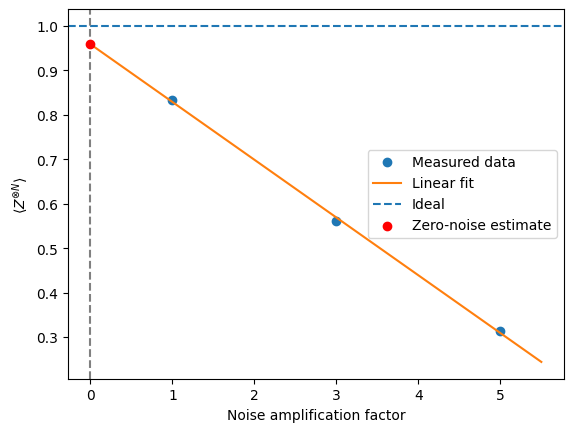
Semasa pelajaran ini dibuat, daripada ekstrapolasi kepada kes hingar sifar, kita memperoleh nilai jangkaan 0.959. Nilai anda mungkin berbeza. Ini jauh lebih baik daripada nilai jangkaan litar mentah iaitu 0.83, kira-kira 13% lebih hampir dengan nilai unggul. Tetapi anda juga dapat melihat bahawa kita menggunakan satu titik data di mana nilai jangkaan jatuh pada 0.31. Jelas sekali titik data ini berkualiti lebih rendah. Jika titik data itu diberi pemberat lebih rendah dalam penghampiran linear kita, dan garis itu disuaikan lebih kepada dua titik data pertama, kita dapat melihat anggaran ekstrapolasi sifar akan lebih tinggi (lebih dekat dengan nilai unggul). Pertimbangan seperti ini dikendalikan secara automatik dalam ZNE terbina dalam Estimator.
ZNE terbina dalam Estimator
Sekarang mari kita lihat apa yang berlaku apabila kita menggunakan fungsi ZNE terbina dalam Estimator. Kita bermula dengan mentakrifkan litar GHZ yang ringkas, tanpa sebarang gate folding.
num_qubits = 10  # must be even

qc = QuantumCircuit(num_qubits)
qc.h(0)

for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=10, num_clbits=0, params=[]), qubits=(<Qubit register=(10, "q"), index=0>, <Qubit register=(10, "q"), index=1>, <Qubit register=(10, "q"), index=2>, <Qubit register=(10, "q"), index=3>, <Qubit register=(10, "q"), index=4>, <Qubit register=(10, "q"), index=5>, <Qubit register=(10, "q"), index=6>, <Qubit register=(10, "q"), index=7>, <Qubit register=(10, "q"), index=8>, <Qubit register=(10, "q"), index=9>), clbits=())
Kita mentakrifkan observabel yang sama seperti sebelum ini.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
Kita sekali lagi mentakrifkan pass manager, menggunakan optimization_level = 1. Kita akan kembali kepada pilihan ini di bawah.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)
Lakukan transpile pada litar dan gunakan susun atur pada observabel.
# Transpile the circuit
qc_transpiled = pm.run(qc)

# Extract the final layout
layout = qc_transpiled.layout

# Apply the layout to the observable
obs_transpiled = observable.apply_layout(layout)
Kita menjalankan Estimator menggunakan ZNE dan twirling, dan kita membandingkan hasilnya dengan pelaksanaan ZNE secara manual kita. Khususnya, kita membandingkannya dengan keputusan tanpa ZNE (value_no_zne).
# This used 18 sec on ibm_fez. Your actual QPU time might vary.

options_zne = {
    "resilience_level": 2,
    "resilience": {
        "zne": {
            "noise_factors": [1, 3, 5],
        }
    },
    "twirling": {
        "enable_gates": True,
        "enable_measure": True,
        "num_randomizations": "auto",
    },
}

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
Kita boleh mendapatkan nilai pada setiap faktor hingar menggunakan sintaks job_zne.result()[0].data.evs_noise_factors. Seperti sebelum ini, kita boleh menggunakan keputusan ini secara naif untuk mendapatkan penyuaian linear dan mengekstrapolasi kepada kes hingar sifar, tetapi estimator dengan resilience_level = 2 telah melakukan kerja yang lebih baik, dengan mengambil kira varians dan pertimbangan lain. Di bawah kita tunjukkan apa yang akan dihasilkan oleh ekstrapolasi linear, dan kita tunjukkan apa yang sebenarnya dihasilkan oleh ZNE terbina dalam.
# Data
noise_factors = np.array([1, 3, 5])
values_qiskit_zne = np.array(job_zne.result()[0].data.evs_noise_factors)

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values_qiskit_zne, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.11745451044574956
Zero-noise extrapolated value: 0.9045922788100509
print("Exp val ideal: 1.0")
print("Exp val with no ZNE: ", value_no_zne)
print("Exp val with ZNE: ", value_zne)
print("Fractional improvement: ", (value_zne - value_no_zne) * 100 / 1.0, "%")
Exp val ideal: 1.0
Exp val with no ZNE:  0.8327970939283861
Exp val with ZNE:  0.9877508802932561
Fractional improvement:  15.495378636487 %
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Linear")
plt.scatter(0, value_zne, color="black", zorder=3, label="Proper ZNE")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
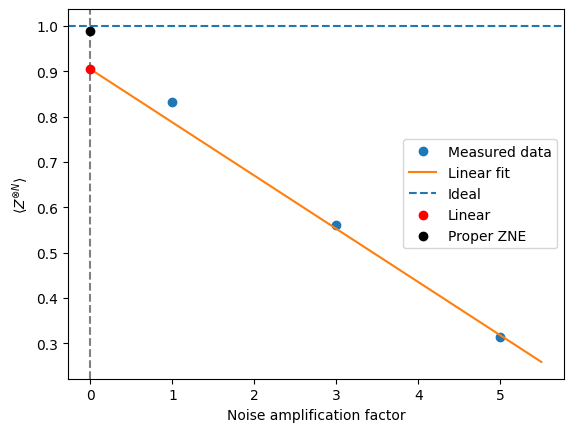
Kita melihat bahawa ZNE terbina dalam memperbaiki anggaran kita lebih daripada 15%, dan berfungsi jauh lebih baik daripada percubaan manual kita.
Sebelum meneruskan, perhatikan bahawa sepanjang penerokaan ZNE ini, kita telah menetapkan optimization_level = 1 dalam pass manager. Tahap pengoptimuman yang lebih tinggi mengurangkan ralat, dan kadangkala pengurangan ralat itu boleh menjadikan ralat berskala kurang boleh diramal. Seperti selalu, terdapat keseimbangan: kurangkan ralat, kecuali apabila anda sengaja meningkatkannya dengan faktor yang diketahui.
Menggabungkan kaedah
ZNE bergantung pada perkara berikut:
-
Parameter penskalaan hingar yang tertakrif dengan baik
-
Penskalaan nilai jangkaan dengan yang cukup lancar dan boleh diramal
-
Saluran hingar berkesan yang sama, pada kekuatan yang berbeza
-
Tiada bias diperkenalkan yang tidak berskala dengan
ZNE boleh digabungkan dengan baik dengan teknik yang menghapuskan bias tidak berskala (seperti M3) atau menjadikan hingar lebih sekata (seperti twirling), tetapi bercanggah dengan teknik yang cuba membatalkan hingar sepenuhnya (PEC) atau membentuk semula hingar secara dinamik (DD).
Khususnya, M3 hanya menangani ralat pengukuran/bacaan, yang dalam praktik boleh dianggap berasingan daripada ralat get (yang menjadi tumpuan proses penskalaan ralat dalam ZNE). M3 sebahagian besarnya bebas daripada gate folding; ia boleh digabungkan dengan bersih bersama ZNE. TREX sangat serupa, dan ia boleh digabungkan dengan ZNE.
Pauli twirling memang menumpukan pada get, tidak seperti M3 dan TREX. Namun, ingat bahawa Pauli twirling tidak memitigasi ralat/hingar secara langsung; sebaliknya, ia mengubahnya supaya lebih boleh diramal. Pauli twirling mungkin sebenarnya bermanfaat kepada proses ZNE dengan menjadikan ralat get berskala lebih linear dan seterusnya menjadikan ekstrapolasi lebih tepat.
Dynamical decoupling (DD) lebih bernuansa. DD mengubah tingkah laku hingar secara dinamik dengan membatalkan sebahagian ralat tertentu melalui penambahan jujukan get. Jika mungkin untuk membina litar sedemikian rupa sehingga DD berkelakuan sama walaupun apabila get atau blok dilipat, maka pada prinsipnya seseorang boleh menggabungkan ZNE dan DD, tetapi dalam praktik DD kadangkala mengganggu penskalaan. Jika anda ingin menggabungkannya, perkara yang perlu dipertimbangkan termasuk yang berikut:
- Adakah DD digunakan secara konsisten pada semua tahap hingar?
- Adakah pelipatan mengekalkan struktur DD?
- Adakah penskalaan hingar yang terhasil masih berkelakuan secara monotonik?
Kaedah pengurangan ralat terakhir yang akan kita bincangkan sebagai pendekatan kendiri tidak serasi dengan ZNE: pembatalan ralat kebarangkalian.
Pembatalan Ralat Kebarangkalian (PEC)
Tidak seperti ZNE atau pengurangan pengukuran, PEC cuba membatalkan hingar pada peringkat gate dengan membina semula saluran unggul dalam jangkaan. Pembatalan Ralat Kebarangkalian (PEC) ialah teknik pengurangan ralat yang paling berkuasa dan paling mahal yang diliputi dalam pelajaran ini. PEC dibina berdasarkan penyongsangan eksplisit saluran hingar, yang dijalankan secara statistik dan bukannya secara fizikal. PEC berfungsi dengan:
-
Mencirikan model hingar dari segi asas "operasi ralat."
-
Menyatakan songsangan saluran hingar sebagai taburan kuasi-kebarangkalian ke atas operasi fizikal.
-
Membuat persampelan daripada taburan ini semasa pelaksanaan litar untuk membina secara statistik anggaran tidak berbias bagi pengiraan unggul.
Secara konsep, PEC adalah seperti pembetulan ralat maya — ia "membuat asal" hingar dengan menggabungkan operasi berhingar dalam corak rawak yang berpemberat dengan teliti. Namun, dari segi prosedur, PEC tidak berkait rapat dengan kod pembetulan atau pengesanan ralat. Anggaran tidak berbias PEC bagi nilai jangkaan unggul tanpa hingar datang dengan kos overhed persampelan yang sangat besar dan pergantungan yang kuat pada pencirian hingar yang tepat.
Pada komputer kuantum IBM, PEC paling baik dilihat sebagai alat ketepatan dan bukannya lapisan pengurangan serba guna: ia paling sesuai untuk litar kecil atau bahagian kecil litar yang lebih besar, tugas penanda aras, dan kajian ketepatan tinggi di mana overhed kuantum yang tinggi boleh diterima.
Mencirikan saluran hingar
Dalam PEC, setiap get unggul dalam litar kuantum dimodelkan sebagai saluran uniter unggul diikuti oleh proses hingar. Biarkan melambangkan matriks ketumpatan keadaan kuantum. Get unggul diwakili oleh matriks uniter , yang mendorong saluran kuantum:
Pada perkakasan sebenar, evolusi unggul ini dicemari oleh hingar. Kita memodelkan pelaksanaan fizikal gate sebagai saluran berhingar berkesan:
di mana ialah saluran hingar yang menangkap ralat stokastik yang berkaitan dengan gate. Sepanjang perbincangan ini, , , dan ialah pemetaan linear yang bertindak pada operator ketumpatan. Saluran unggul adalah uniter dan boleh balik, manakala saluran hingar (dan seterusnya ) ialah pemetaan positif sepenuhnya yang memelihara surih (CPTP).
PEC mengandaikan bahawa saluran hingar diketahui atau diketahui secara hampir. Pada perkakasan IBM Quantum, maklumat ini lazimnya diperoleh daripada data penentukuran peranti, kadar ralat yang disimpulkan daripada eksperimen penanda aras, dan model hingar dipermudah seperti penghampiran Pauli atau depolarisasi bagi set gate yang kecil. Walaupun PEC tidak memerlukan model hingar yang tepat sepenuhnya, prestasinya merosot dengan pantas apabila saluran hingar yang diandaikan menyimpang daripada tingkah laku perkakasan sebenar.
Penguraian kuasi-kebarangkalian bagi saluran hingar songsang
Idea utama PEC ialah membatalkan kesan hingar dalam jangkaan dengan membina penghampiran stokastik bagi songsangan saluran hingar. Secara formal, matlamatnya ialah menggunakan pemetaan linear yang hampir membuat asal , supaya:
dalam jangkaan ke atas banyak pelaksanaan litar.
Songsangan ditakrifkan di sini sebagai songsangan algebra bagi yang dianggap sebagai superoperator linear yang bertindak pada operator. Songsangan ini wujud hanya jika berpangkat penuh; proses hingar tidak boleh songsang tidak boleh dimitigasi dengan tepat menggunakan PEC.
Apabila penyongsangan mungkin, PEC menyatakan saluran hingar songsang sebagai gabungan linear operasi yang boleh dilaksanakan secara fizikal:
Di sini, setiap ialah operasi berhingar yang boleh dilaksanakan pada perkakasan (lazimnya gate natif atau jujukan gate pendek), dan pekali nyata membentuk taburan kuasi-kebarangkalian. Tidak seperti kebarangkalian biasa, pekali mungkin negatif atau melebihi 1.
Norma kuasi-kebarangkalian:
mengukur kos penyongsangan hingar. Bagi mana-mana saluran hingar yang tidak remeh, . Pada perkakasan IBM Quantum, penguraian ini lazimnya dilakukan:
- bagi setiap gate atau setiap set gate kecil,
- dengan mengandaikan model hingar terhad (sering penghampiran pepenjuru Pauli),
- menggunakan operasi natif khusus Backend dan kekangan penjadualan.
Pembinaan semula Monte Carlo bagi litar unggul
Untuk menganggarkan nilai jangkaan bagi observabel , PEC menggunakan persampelan Monte Carlo berdasarkan penguraian di atas. Bagi setiap kemunculan get berhingar dalam litar, prosedur berikut digunakan:
-
Pilih secara rawak satu operasi dengan kebarangkalian:
-
Tetapkan pemberat klasik:
-
Laksanakan litar berhingar rawak yang terhasil pada Backend kuantum.
-
Darabkan hasil yang diukur dengan hasil darab semua pemberat terkumpul.
-
Purata keputusan berpemberat ke atas banyak pelaksanaan litar.
Penganggar yang terhasil memenuhi
selagi model hingar menerangkan perkakasan dengan tepat. Oleh itu PEC memperkenalkan tiada pincang sistematik dalam jangkaan, tetapi menggantikan pincang dengan varians statistik yang besar. Setiap larian menghasilkan anggaran berhingar tetapi berpemberat; hanya selepas mengambil purata banyak larian sedemikian barulah nilai jangkaan unggul muncul.
Tafsiran konseptual
PEC kadangkala digambarkan sebagai pembetulan ralat maya. Walaupun frasa ini tidak sepenuhnya salah, ia tidak boleh dikelirukan dengan pembetulan ralat kuantum sebenar. PEC tidak melibatkan pengekodan logik, tiada pengekstrakan sindrom, dan tiada maklum balas masa nyata. Ralat tidak dicegah atau dibetulkan semasa pelaksanaan litar.
Sebaliknya, PEC membatalkan hingar secara statistik, dengan menggabungkan banyak realisasi litar berhingar dengan pemberat klasik bertanda supaya ralat hanya dibatalkan selepas pascapemprosesan klasik. Maklumat tidak dilindungi semasa pelaksanaan; keputusan unggul dibina semula selepas kejadian.
Penskalaan sumber dan kos
Kos dominan PEC berpunca daripada penguatan varians. Varians penganggar PEC berskala sebagai:
yang membayangkan:
Penskalaan ini adalah asas dan tidak dapat diperbaiki melalui pascapemprosesan klasik.
Bagi litar yang mengandungi banyak gate berhingar, setiap gate menyumbang faktor , menyebabkan jumlah norma kuasi-kebarangkalian meningkat kira-kira secara berganda:
di mana ialah kedalaman litar. Pada perkakasan IBM Quantum, ini lazimnya membawa kepada pertumbuhan eksponen dalam kos persampelan dengan kedalaman litar, dengan kepekaan yang amat kuat terhadap ralat gate dua qubit. Penskalaan ini meletakkan had praktikal pada kebolehgunaan PEC.
PEC pada masa ini hanya praktikal apabila satu atau semua keadaan berikut dipenuhi:
-
Litar sangat kecil atau cetek (selalunya get),
-
Model hingar mudah dan telah disahkan dengan baik (contohnya, hingar Pauli),
-
Kos statistik yang tinggi boleh diterima,
-
Matlamatnya ialah ketepatan dan bukannya daya pemprosesan.
Atas sebab ini, PEC sering digunakan pada:
-
Sublitar terpencil dalam aliran kerja yang lebih besar,
-
Langkah evolusi masa singkat,
-
Rutin penyediaan keadaan atau pengukuran,
-
Eksperimen penanda aras dan pengesahan.
Timbunan perisian IBM (IBM Quantum Compute dan alatan pengurangan ralat) mencerminkan hal ini dengan menganggap PEC sebagai pilihan khusus, bukan lapisan pengurangan lalai.
Kes penggunaan PEC yang lazim termasuk:
-
Penanda aras ketepatan perkakasan kuantum,
-
Pengesahan algoritma kuantum kecil,
-
Kimia kuantum berketepatan tinggi pada sistem yang dikurangkan,
-
Semakan silang ZNE atau kaedah pengurangan lain.
Hubungan PEC dengan kaedah pengurangan lain
Banyak teknik pengurangan lain mengorbankan ketepatan demi kebolehskalaan; PEC melakukan sebaliknya, menumpukan pada ketepatan melebihi segala-galanya.
Oleh sebab PEC mungkin hanya digunakan pada sublitar, adalah amat penting di sini untuk bertanya kaedah pengurangan lain yang boleh digabungkan dengannya. Untuk membuat penaakulan yang jelas tentang keserasian dengan PEC, adalah berguna untuk mengkategorikan teknik mengikut kesannya terhadap hingar. Pertimbangkan kategori umum berikut:
-
Pembatalan hingar - cuba menyongsangkan saluran ralat
-
Penskalaan hingar - sengaja meningkatkan hingar untuk membuat ekstrapolasi
-
Pembentukan semula hingar - mengubah struktur atau spektrum hingar
-
Penyingkiran pincang - membetulkan ralat yang tidak berskala dengan hingar gate
PEC terletak tepat dalam kategori (1). Mana-mana kaedah yang mengubah atau menskalakan semula saluran hingar mesti diteliti dengan berhati-hati.
Jadual ringkasan (peringkat tinggi)
| Teknik | Serasi dengan PEC | Catatan |
|---|---|---|
| ZNE | Tidak | Membatalkan berbanding menskalakan dan kadangkala menyesuaikan ralat |
| Pauli twirling | Ya (dengan berhati-hati) | Menjejaskan tingkah laku ralat, tetapi mungkin menjadikannya lebih mudah dipelajari |
| TREX | Ya | Tiada pertindihan dalam aliran kerja. Sepenuhnya serasi. |
| Dynamical decoupling | Biasanya tidak | Mengubah saluran ralat |
PEC dan ZNE menangani sumber ralat yang sama (ralat gate) melalui andaian atau aliran kerja yang saling tidak serasi, atau kedua-duanya. Sebagai contoh, dalam ZNE, kita menganggap ralat boleh dikembangkan dalam parameter :
dan ralat itu boleh diskalakan dengan berkesan untuk memodelkan pengembangan ini. PEC akan membatalkan ralat yang menjadi asas penskalaan itu. Parameter akan menjadi tidak bermakna. Cara lain untuk memikirkannya ialah:
-
Menggunakan ZNE sebelum PEC mengubah saluran hingar yang cuba anda songsangkan.
-
Menggunakan PEC sebelum ZNE menyingkirkan hingar yang menjadi asas ekstrapolasi ZNE.
PEC dan ZNE harus dianggap sebagai paradigma pengurangan ralat alternatif, bukan lapisan yang boleh digubah. Membandingkan keduanya secara bersebelahan adalah bermanfaat, manakala menggabungkannya tidak.
PEC dan Pauli twirling pada amnya serasi dan sering bermanfaat. Twirling mungkin membantu PEC kerana twirling menukar ralat koheren kepada ralat Pauli stokastik. Ini memudahkan saluran hingar, menjadikannya lebih mudah diwakili dan disongsangkan. Bagi PEC, ini amat bernilai, atas sebab-sebab berikut:
-
Penguraian kuasi-kebarangkalian jauh lebih mudah untuk saluran Pauli
-
Norma kuasi-kebarangkalian sering jauh lebih kecil
-
Varians pensampelan dikurangkan
Banyak demonstrasi PEC menganggap atau membina hingar yang telah di-Pauli-twirl. Adalah penting untuk menjelaskan bahawa Pauli twirling tidak memitigasi ralat dengan sendirinya; ia membentuk semula hingar kepada bentuk yang boleh dikendalikan dengan lebih cekap oleh pembatalan ralat probabilistik.
PEC boleh dan harus digabungkan dengan TREX. Pendekatan ini sepenuhnya serasi dan memainkan peranan ortogon. TREX hanya beroperasi pada pengukuran, menyingkirkan pincang bacaan melalui twirl rawak saluran pengukuran, dan tidak menjejaskan hingar gate atau dinamik litar. PEC beroperasi pada hingar gate. Oleh sebab ralat pengukuran bersifat tambahan dan bukan kompositional, ia tidak bergantung pada jujukan gate. Adalah selamat dan sering diingini untuk menggunakan TREX bersama PEC.
Susunan kaedah ini adalah seperti yang anda jangkakan:
- Laksanakan litar rawak-PEC
- Gunakan TREX untuk memitigasi ralat bacaan
- Gunakan pemberat dan purata PEC
PEC dan DD pada amnya tidak serasi melainkan pencirian hingar yang digunakan untuk PEC dilakukan dengan DD aktif. PEC menganggap bahawa adalah pegun, boleh diulang, dan boleh dicirikan dengan tepat. DD secara eksplisit membentuk semula saluran hingar dalam masa dengan memodulasi interaksi sistem-persekitaran dan memperkenalkan kesan pemasaan denyut yang tidak remeh. Akibatnya, hingar berkesan dengan DD bukan saluran yang sama seperti tanpa DD. Ini menjadi lebih kompleks lagi kerana saluran hingar boleh bergantung dengan sensitif pada penjadualan litar. Hasil akhirnya ialah penyongsangan hingar menjadi tidak tertakrif atau tidak sah.
Secara teori, adalah mungkin untuk mencirikan hingar dengan DD aktif dan membina model PEC dengan sewajarnya, tetapi ini sangat lanjutan dan bukan aliran kerja yang disyorkan pada masa ini.
Menggunakan PEC secara manual
PEC adalah kompleks dan tidak disyorkan anda melaksanakannya secara manual. Walaupun begitu, kita ingin menyelesaikan matematik bagi aplikasi asas pada satu qubit untuk memahami langkah yang terlibat dalam proses ini. Kita memilih keadaan campuran tetapi tidak remeh supaya kita dapat melihat kesan berangka dengan jelas.
Ambil satu qubit yang sepatutnya berada dalam keadaan tulen
Matriks ketumpatan unggul ialah:
Kita memilih matriks ketumpatan ini kerana ia bukan pepenjuru dan hanya untuk satu qubit supaya mudah diperiksa "secara manual".
Kini kita menggunakan model hingar yang sangat mudah, tetapi realistik: saluran depolarisasi satu qubit, dengan kekuatan kecil .
Untuk memudahkan aritmetik, ambil . Saluran ini positif sepenuhnya dan mengekalkan surih (CPTP), sebagaimana yang sepatutnya. Ia ialah saluran hingar yang realistik untuk perkakasan sebenar, atau sekurang-kurangnya realistik untuk menerangkan sebahagian hingar. Selanjutnya, saluran hingar ini boleh disongsangkan secara analitik, sebagai peta linear. Dalam erti kata lain, wujud matriks songsang, tetapi itu tidak bermakna matriks tersebut sepadan dengan saluran fizikal CPTP, dan ia pastinya tidak sepadan dengan uniter yang boleh dilaksanakan pada perkakasan.
Sekarang kita menggunakan saluran hingar depolarisasi kita pada matriks ketumpatan satu qubit kita dan memperoleh:
Dengan : dan .
So:
Menggunakan ini pada keadaan kita:
Hitung secara eksplisit:
Ini masih matriks ketumpatan fizikal, dan ia masih mempunyai surih satu — tetapi kini ia lebih bercampur.
Sekarang kita mengira saluran songsang unggul, tetapi bersedia sepenuhnya untuk kemungkinan bahawa ia mungkin tidak fizikal. Kita akan menyemak sama ada ia fizikal. Secara matematik, peta linear songsang ialah:
Jika tindakan songsang ini sendiri ialah saluran fizikal yang sah, maka kita akan tergoda untuk cuba melaksanakannya dengan tepat. Sudah tentu, kita masih perlu mencari cara untuk melaksanakannya menggunakan operasi unitari dan langkah klasik, tetapi melaksanakannya akan menjadi matlamat. Walau bagaimanapun, ternyata ini bukan CPTP, dan pada amnya tiada jaminan bahawa pemetaan songsang sedemikian akan menjadi CPTP. Itu penting untuk perbincangan kita sekarang, kerana itulah sebab PEC wujud.
Anda mungkin dapat melihat bahawa ia bukan CPTP hanya dengan melihatnya. Semakan yang pasti ialah menggunakannya pada matriks ketumpatan dan melihat sama ada ia memberikan hasil yang fizikal. Ini ditinggalkan sebagai latihan untuk menyemak kefahaman anda.
Semak kefahaman anda
Semak sama ada pemetaan songsang di atas ialah CPTP dengan menggunakannya pada matriks ketumpatan baharu:
Tafsirkan hasilnya sebagai fizikal atau bukan fizikal.
Jawapan
Sebagai matriks ketumpatan fizikal, ini sepadan dengan kebarangkalian klasik lebih besar daripada 1 bahawa sistem berada dalam keadaan dan kebarangkalian negatif untuk berada dalam keadaan . Jelas sekali pemetaan ini boleh menghasilkan matriks ketumpatan yang tidak masuk akal. Selanjutnya, melalui pemeriksaan kita dapat melihat bahawa nilai eigen bagi matriks ketumpatan yang terhasil ialah 1.0625 dan -0.0625, bermakna bukan semua nilai eigen adalah positif. Oleh itu pemetaan ini bukan "positif sepenuhnya", iaitu "CP" dalam CPTP.
Semak kefahaman anda
Semak melalui pengiraan eksplisit bahawa operasi songsang di atas membatalkan saluran hingar dan mengembalikan keadaan tanpa hingar.
Jawapan
Gunakannya pada keadaan berhingar:
Ini betul-betul keadaan asal (sehingga pembundaran).
Kita nyatakan semula agar benar-benar jelas: kita tidak boleh menyongsangkan saluran hingar dengan tepat; songsangnya bukan CPTP, dan ia juga bukan saluran fizikal yang sah. Walau bagaimanapun, kita boleh menyongsangkan saluran itu dengan berkesan sebagai gabungan linear saluran fizikal.
Untuk saluran depolarisasi:
dengan: dan seterusnya.
Songsangnya boleh ditulis sebagai:
with:
-
= saluran Clifford yang boleh dilaksanakan secara fizikal
-
= kuasi-kebarangkalian
-
Some
Ini ialah idea teras di sebalik PEC:
-
Sampel saluran mengikut ∣
-
Lampirkan tanda pada hasil pengukuran
-
Nilai jangkaan menumpu kepada nilai tanpa hingar
Kita menggunakan PEC "secara manual" pada penganggaran dengan menggunakan matriks ketumpatan dan melihat sama ada kita dapat memulihkan hasil untuk . Untuk kita jangkakan:
Perhatikan juga bahawa untuk matriks ketumpatan berhingar, kita memperoleh:
Ia berada pada tertib magnitud yang betul tetapi jauh berbeza daripada kes unggul.
Sekarang kita meneliti bagaimana, dengan proses PEC, kita boleh membina semula nilai jangkaan tidak pincang daripada matriks ketumpatan berhingar. Dalam aliran kerja sebenar, ini bersifat probabilistik dan akan diautomasikan. Dalam aliran kerja "manual" ini, kita akan memilih nilai probabilistik yang realistik, tetapi mungkin mudah untuk pembentangan kita. Ini tidak harus dianggap sebagai dakwaan bahawa PEC adalah sempurna. Ini hanyalah untuk menunjukkan kepada anda senario munasabah yang boleh berlaku di dalam pakej PEC.
Ingat bahawa saluran hingar kita berbentuk:
Songsangnya boleh ditulis (dengan tepat):
based on symmetry of the transformation and the completeness of the Pauli operators. Inverting the noise channel somehow in the estimation process should yield an estimator that is unbiased and normalized. To do this, we must at least determine the coefficents and and then think about how to implement the inverse transformation. When done by a noise learner, the inversion of this noise channel would be done at the channel level, independent of a specific case like our density matrix. The coefficients and would come from this inversion.
Untuk pengenalan ini, lebih mudah menumpukan pada kesan saluran terhadap matriks ketumpatan kita. Ini membolehkan kita bekerja dengan objek yang biasa seperti matriks ketumpatan dan nilai jangkaan. Untuk tujuan itu, pertimbangkan apa yang mesti benar tentang kesan operasi songsang ini terhadap proses penganggaran kita: penganggar yang dihasilkan oleh PEC mestilah ternormal dan tidak pincang. Ini sepadan dengan dua syarat:
-
Normalisasi: Untuk memastikan operasi ini tidak mengubah skala observable, kita memerlukan . Untuk melihat mengapa begitu, kita boleh mempertimbangkan tindakan songsang pada matriks ketumpatan, atau mempertimbangkan tindakannya pada nilai jangkaan sesuatu yang remeh seperti itu sendiri.
-
Penentukuran: Dalam aliran kerja sebenar, kita menggunakan litar penentukuran untuk mempelajari tingkah laku hingar pada peringkat gate. Kita kemudian menggunakan pengetahuan peringkat gate tentang tingkah laku hingar, dan kelinearan nilai jangkaan untuk menggunakan model hingar yang dipelajari pada litar yang lebih besar. Dalam kes kita, kita bermula dengan pengetahuan buatan bahawa nilai jangkaan unggul ialah . Tetapi adalah sangat mudah untuk mencipta keadaan yang secara teori kita tahu bahawa ini ialah nilai unggul, dan kemudian menggunakan pengukuran sebenar untuk penentukuran. Satu perkara utama ialah bagi PEC, biasanya seseorang tidak mempelajari model hingar penuh bagi keseluruhan litar. Sebaliknya, seseorang mempelajari model hingar tempatan untuk gate atau lapisan litar individu dan menggunakannya untuk membina penguraian kuasi-kebarangkalian.
Kita menggunakan syarat-syarat ini untuk menentukan dan . Kita pertimbangkan ansatz
and apply it to an arbitrary single-qubit density matrix .
Ingat bahawa saluran Pauli bertindak melalui konjugasi:
Menggunakan pada memberikan:
Mengambil surih, kita memperoleh:
Setiap pengendali Pauli ialah unitari, supaya konjugasi mengekalkan surih:
Therefore,
Agar penganggar PEC ternormal, peta songsang berkesan mesti mengekalkan surih semua matriks ketumpatan. Iaitu, kita memerlukan:
Ini membayangkan kekangan normalisasi:
Tetapi dalam kes kita, ini menghasilkan syarat:
Sekarang kita menggunakan maklumat penentukuran untuk mengaitkan nilai jangkaan yang diperhatikan dengan nilai unggul yang diketahui.
Or equivalently,
Menyelesaikan dua syarat kita untuk dan , kita memperoleh:
Pekali ini berjumlah 1, tetapi salah satunya negatif.
Kita boleh memulihkan nilai jangkaan unggul dengan mengubah suai litar secara rawak, mengukur, mendarabkan hasilnya dengan pemberat bertanda, dan mengambil purata. Khususnya, tiada matriks ketumpatan dibina semula dan tiada saluran songsang dilaksanakan secara fizikal.
Langkah utama: inilah PEC
Untuk kekuatan hingar kita , saluran songsang boleh ditulis sebagai:
Fakta penting:
-
Pekali berjumlah 1
-
Satu pekali adalah negatif
-
Setiap sebutan boleh dilaksanakan secara fizikal
-
Kenegatifan dipindahkan ke pasca-pemprosesan klasik
Kita membentuk taburan pensampelan daripada nilai mutlak pemberat:
(untuk setiap X, Y, Z)
Jumlah pemberat:
Untuk kebarangkalian pensampelan, bahagikan dengan W.
| Operasi | Kebarangkalian | Tanda |
|---|---|---|
| Tidak buat apa-apa () | 1.1875 / 1.375 ≈ 0.864 | + |
| Gunakan X | 0.0625 / 1.375 ≈ 0.045 | - |
| Gunakan Y | 0.0625 / 1.375 ≈ 0.045 | - |
| Gunakan Z | 0.0625 / 1.375 ≈ 0.045 | - |
Tanda datang daripada pekali asal, bukan kebarangkalian.
Setiap shot terdiri daripada langkah berikut:
-
Sediakan keadaan
-
Biarkan perkakasan menggunakan litar berhingar
-
Pilih operasi secara rawak daripada jadual di atas menggunakan kebarangkalian yang berkaitan
-
Apply it
-
Ukur , mendapat
-
Darabkan hasilnya dengan
-
Rekodkan nombor itu
Kita kini membuat contoh beberapa shot.
Shot 1 (kes identiti)
Andaikan operasi yang dipilih secara rawak ialah identiti (atau setara: tidak buat apa-apa). Berdasarkan hujah dan jadual di atas, ini akan berlaku 86.4% daripada masa. Oleh sebab pekali dalam songsang saluran hingar adalah positif, kita memilih tanda . Pengukuran Z kita boleh dengan mudah menghasilkan sama ada . Katakan ia menghasilkan .
Sumbangan terbetulkan-PEC daripada shot ini ialah:
Shot 2 (identiti sekali lagi)
Andaikan kita sekali lagi memperoleh sebagai operasi rawak kita (jadi tanda sebutan itu pada mulanya masih ), tetapi kali ini pengukuran Z kita menghasilkan . Kali ini sumbangannya ialah:
Shot 3 (X dipilih)
Kali ini operasi rawak kita ialah X. Sebutan ini dalam songsang adalah negatif, jadi kita mengekalkan tanda . Kita menggunakan X dan kemudian mengukur Z. Sekali lagi, kita boleh memperoleh sama ada nilai eigen; katakan kita memperoleh . Sumbangan daripada sebutan ini ialah:
Shot 4 (Z dipilih)
Operasi rawak ialah Z. Ini memberi kita tanda daripada jadual. Andaikan kita mengukur Z dan memperoleh . Sumbangannya ialah:
Shot 5 (Y dipilih)
Operasi rawak ialah Y. Ini memberi kita tanda daripada jadual. Andaikan kita mengukur Z dan memperoleh . Sumbangannya ialah:
Mengambil purata hasil
Bayangkan kita mengumpul banyak hasil berpemberat-PEC sedemikian:
Mengikut pembinaan, kita menggunakan identiti 86.4% daripada masa. Kita menggunakan setiap gate lain 4.5% daripada masa. Dalam aliran kerja sebenar, kita tidak tahu keadaan asas yang tepat, mahupun keseluruhan saluran hingar. Tetapi kita tahu faktor pemberat dari atas, dan kebarangkalian relatif untuk kita menggunakan setiap operasi. Dalam aliran kerja sebenar, kita bergantung pada matriks ketumpatan yang tidak diketahui untuk memberi kita hasil pengukuran. Kita akan mengesahkan di sini bahawa prosedur ini akan menghasilkan keputusan yang betul.
Kita ingin mengira purata semua pengukuran berpemberat dan bertanda termasuk penggunaan pengendali Pauli sebelum pengukuran. Panggil jumlah bilangan semua shot . Panggil set semua shot yang Pauli digunakan sebagai dan gunakan untuk mengindeks shot ini. Panggil hasil pengukuran shot ke- di bawah penggunaan Pauli ke- sebagai . Kita boleh menulis purata ini sebagai:
Pengendali Pauli digunakan secara probabilistik dengan kebarangkalian . Dalam had bilangan shot yang besar,
Kita boleh menggunakan ini untuk menulis:
dengan ialah nilai jangkaan Z hanya ke atas ensembel shot yang digunakan. Ini berguna kerana kita tahu apakah setiap nilai jangkaan sedemikian mestinya daripada matriks ketumpatan. Sekali lagi, dalam aliran kerja sebenar, ini akan datang daripada pengukuran, bukan daripada matriks ketumpatan yang diketahui.
Semak kefahaman anda
Sahkan nilai jangkaan di atas melalui pengiraan atau penaakulan logik.
Jawapan
Y dan Z dikendalikan dengan cara yang sama seperti di atas.
Sekarang kita boleh menulis semula nilai jangkaan keseluruhan kita sebagai:
Jika kita mengetahui parameter dan bagi hingar gate kita (atau lebih banyak parameter untuk saluran hingar yang lebih kompleks), itu sudah memadai untuk menentukan (1) faktor pemberat keseluruhan, dan (2) kebarangkalian untuk kita menggunakan pengendali Pauli. Apa yang ditunjukkan oleh keputusan di atas ialah jika kita melakukannya, kita mengurangkan hingar dan memulihkan nilai jangkaan yang tidak berat sebelah. Purata bagi semua shot ini menumpu kepada , walaupun:
-
Shot individu memberikan sumbangan yang lebih besar daripada ±1
-
Sesetengah shot mempunyai pemberat statistik yang negatif
-
Setiap operasi kuantum adalah fizikal
Gambaran keseluruhan aliran kerja PEC
Dalam PEC, semua langkah pada komputer kuantum ialah:
-
Pembelajaran hingar
-
Penyediaan keadaan untuk litar sasaran anda
-
Gunakan gate Pauli secara kebarangkalian seperti yang diterangkan di atas
-
Measurement
Peta hingar songsang yang berkesan direalisasikan secara statistik dalam pasca-pemprosesan klasik. Ini membolehkan penyongsangan saluran hingar yang lebih umum yang sebaliknya memerlukan langkah tidak fizikal seperti kebarangkalian negatif.
Harga yang kita bayar untuk ini ialah varians. Setiap shot sebelum ini mempunyai "magnitud" yang sama dengan magnitud hasil pengukuran yang mungkin . Selepas penskalaan dengan faktor pemberat , magnitudnya menjadi (1.375 dalam contoh kita di atas).
Itulah punca overhead pensampelan PEC.
PEC terbina dalam
Sekarang kita akan menggunakan PEC seperti yang terbina dalam primitif IBM Quantum. Di sini penting untuk membezakan antara PEC peringkat gate penuh dengan model pembelajaran hingar tempatan untuk PEC yang lebih berskala, yang digunakan oleh primitif IBM Quantum. Overhed menggunakan PEC penuh akan mengehadkan penggunaannya kepada litar kecil. Itu tidak mengapa, tetapi lebih berguna untuk mempunyai alat yang boleh diskalakan ke saiz di mana pengkomputeran kuantum menjadi bernilai untuk masalah dunia sebenar. Atas sebab ini, primitif IBM Quantum menggunakan PEC mengikut lapisan dengan model hingar Pauli-Lindblad yang dipelajari, dengan perlindungan kebolehskalaan yang agresif. Dalam pelaksanaan PEC ini, hingar dipelajari bagi setiap lapisan litar yang berulang, bukan bagi setiap contoh gate, dan model hingar tersebut ialah Pauli-twirled, tempatan dan Markovian. Gate Clifford diserap ke dalam model hingar, manakala gate bukan Clifford mendominasi kos pengurangan. Overhed pensampelan dihadkan untuk mengelakkan letusan eksponen.
Kita akan menggunakan PEC yang terbina dalam primitif IBM Quantum pada dua skala: kecil (enam qubit) dan bersaiz sederhana (30 qubit) untuk melihat bagaimana kos dikawal dalam versi PEC ini. Dalam setiap eksperimen saiz, kita juga akan membandingkan secara eksplisit keputusan PEC dengan keputusan tanpa pengurangan, dengan ZNE, dan dengan nilai unggul.
Kita mulakan dengan mengimport beberapa pakej yang diperlukan.
import numpy as np

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp, Statevector

# from qiskit_aer import AerSimulator
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    # QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
Kita memilih observable untuk dianggarkan. Observable di bawah ialah Hamiltonian bagi rantai spin seakan-Ising dengan gandingan jiran terdekat sahaja pada komponen interaksi mereka, dan satu sebutan qubit tunggal dalam , seolah-olah disebabkan oleh medan luar dalam .
Tiada sebab istimewa untuk pemilihan Hamiltonian ini. Kita hanya memerlukan gabungan observable dan litar yang tidak remeh supaya pengurangan ralat dapat berfungsi. Kita menskala Hamiltonian secara eksplisit (menggunakan pekali), dengan membahagikan bilangan qubit supaya tenaga kekal pada susunan magnitud yang sama apabila kita menambah bilangan qubit. Kita bermula dengan hanya enam.
# This cell builds the observable

num_qubits = 6

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)
Seperti dalam pemilihan Hamiltonian, litar untuk penyediaan keadaan di bawah tidak dipilih atas sebab fizikal. Sebaliknya, ia dipilih supaya mempunyai kedalaman dua-qubit yang mencukupi dan gate bukan Clifford yang cukup banyak supaya PEC boleh berguna. Tiada sebab untuk menganggap litar ini sebagai penghampiran yang baik bagi keadaan dasar rantai spin ini, sebagai contoh.
qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.5, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)
qc.rz(3.141592653589793 / 8, 2)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")
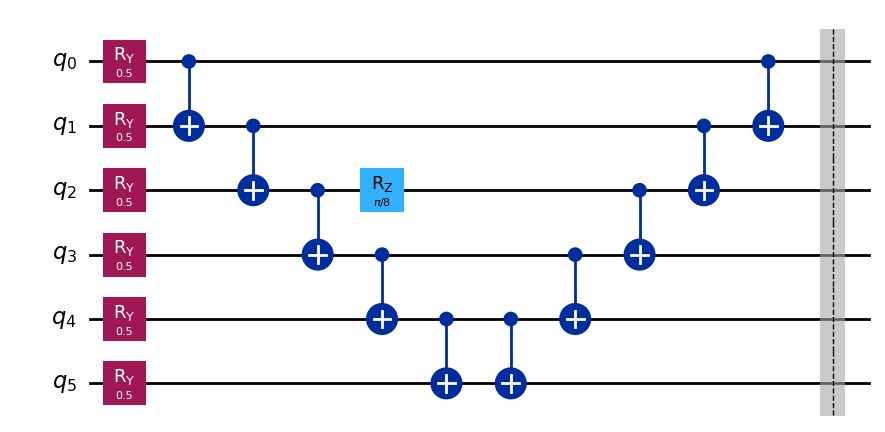
Kita mentranspil litar kita dan menggunakan susun atur yang terhasil pada observable kita.
# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)
Kita memperoleh nilai jangkaan ideal menggunakan simulator Statevector.
# Compute the ideal final state
state = Statevector.from_instruction(qc)

# Compute expectation value
ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.6651408876730361
Kita menjangkakan nilai unggul yang lain akan mempunyai saiz yang serupa. Sekarang kita jalankan ini pada komputer kuantum IBM sebenar tanpa pengurangan ralat.
# This took 3 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.569677734375
Sekarang kita gunakan ZNE pada masalah yang sama.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.6573718927156127
Akhir sekali, kita gunakan PEC.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

from qiskit_ibm_runtime.options import EstimatorOptions

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

result = job_pec.result()
value_pec = result[0].data.evs

print("PEC:", value_pec)
PEC: 0.6666196849843695
Di bawah kita plotkan keputusan kita dan membandingkannya.
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
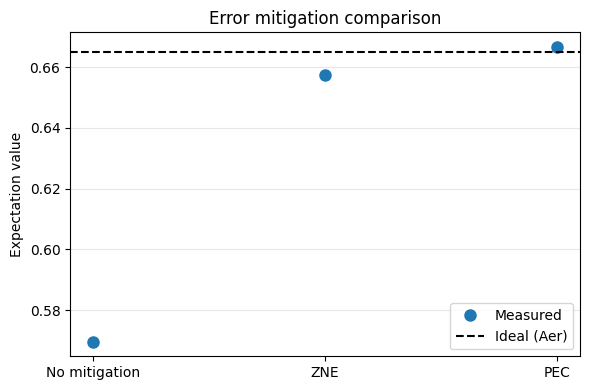
Ini berfungsi dengan sangat baik. Anggaran kita menggunakan PEC hanya 0.2% daripada nilai ideal.
Tetapi ingat bagaimana overhead kuantum meningkat secara eksponen. Kita menguatkuasakan overhead maksimum max_overhead = 100. Berdasarkan masa dan kualiti keputusan, nampaknya kita mungkin tidak mencapai maksimum itu. Walau bagaimanapun, jika kita menskalakan pengiraan kita dan mengekalkan maksimum itu, kita akan mencapainya, dan keputusan kita akan terjejas.
Kita boleh melihat apa yang berlaku apabila kita menskalakan litar kita ke 30 qubit. Menariknya, pada kebanyakan komputer riba simulator Statevector akan mula tamat masa sekitar 24-28 qubit. Kita boleh mencari jalan pengiraan untuk mengatasinya. Tetapi sebaliknya, mari kita terima hakikat bahawa komputer kuantum akan dapat menyelesaikan sesetengah masalah pada skala yang tidak dapat diikuti oleh komputer klasik. Itulah intinya. Jadi, apakah yang boleh kita lakukan untuk mengesahkan keputusan pengkomputeran kuantum kita dalam kes sedemikian? Terdapat beberapa jawapan yang berpotensi:
- Sesetengah masalah sukar diselesaikan tetapi mudah disemak (seperti pemfaktoran perdana dalam algoritma Shor).
- Sesetengah masalah mempunyai rejim parameter atau variasi masalah yang kompleksitinya berkurang dan boleh diselesaikan secara klasik, atau malah secara analisis, untuk membandingkan beberapa titik. Dalam kes ini, kita memilih Hamiltonian yang intrinsik (kita membahagikan bilangan qubit). Nilai jangkaan ideal sepatutnya agak stabil. Mari kita lihat bagaimana nilai jangkaan ideal berubah mengikut bilangan qubit dan lihat sama ada kita boleh membuat ramalan klasik tentang nilai pada 30 qubit.
import numpy as np
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit
from qiskit.quantum_info import Statevector, SparsePauliOp

num_qubits_max = 24

qubits = [4, 8, 12, 16, 20, 24]
exp_vals = []
for num_qubits in qubits:
    qc = QuantumCircuit(num_qubits)

    for i in range(num_qubits):
        qc.ry(0.7, i)
    for i in range(num_qubits - 1):
        qc.cx(i, i + 1)
    for i in range(num_qubits):
        qc.rz(np.pi / 5, i)
    for i in reversed(range(num_qubits - 1)):
        qc.cx(i, i + 1)
    qc.barrier()

    terms = []
    coeffs = []

    # XX interactions
    for i in range(num_qubits - 1):
        pauli = ["I"] * num_qubits
        pauli[i] = "X"
        pauli[i + 1] = "X"
        terms.append("".join(pauli))
        coeffs.append(1.0 / (num_qubits - 1))

    # Z fields
    for i in range(num_qubits):
        pauli = ["I"] * num_qubits
        pauli[i] = "Z"
        terms.append("".join(pauli))
        coeffs.append(0.5 / num_qubits)

    observable = SparsePauliOp(terms, coeffs)

    # Compute the ideal final state
    state = Statevector.from_instruction(qc)

    # Compute expectation value
    ideal_value = np.real(state.expectation_value(observable))
    exp_vals.append(ideal_value)

print(exp_vals)

plt.figure()
plt.plot(qubits, exp_vals, "o", label="Statevector")
plt.xlabel("Number of qubits")
plt.ylabel(r"$\langle O^{\otimes N} \rangle$")
plt.legend()
plt.show()
[np.float64(0.7181764372838925), np.float64(0.7181764372838922), np.float64(0.7181764372838931), np.float64(0.7181764372838906), np.float64(0.7181764372838907), np.float64(0.7181764372838709)]
Sesungguhnya, kita melihat bahawa kita telah memilih Hamiltonian dan keadaan yang tidak berubah dengan bilangan qubit. Ini penggunaan yang sangat lemah untuk aplikasi penyelidikan pengkomputeran kuantum, tetapi sangat sesuai untuk membuat penanda aras teknik pengurangan ralat. Kita boleh dengan yakin menggunakan nilai jangkaan tetap ini sebagai hasil unggul, walaupun kita menambah bilangan qubit untuk menguji pengurangan ralat.
num_qubits = 30

qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.7, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)

for i in range(num_qubits):
    qc.rz(np.pi / 5, i)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")

# This cell builds the observable

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)

# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)

# Compute the ideal final state
# This might time out above about 26 qubits. The Hamiltonian has been "normalized".
# The same expectation value calculated on the smaller example above is still valid.
# state = Statevector.from_instruction(qc)

# Compute expectation value
# ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.7181764372838709
# This took 5 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.5869884271731322
Sekarang kita jalankan litar yang lebih besar ini dengan ZNE.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.7096089981595511
Akhir sekali, kita jalankan contoh 30 qubit dengan PEC.
# This took 4 min 57 sec on ibm_fez. Your actual runtime might vary.

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

value_pec = job_pec.result()[0].data.evs
print("PEC:", value_pec)
PEC: 0.3481257778627795
job_id_none = job_none.job_id()
job_id_zne = job_zne.job_id()
job_id_pec = job_pec.job_id()
print("job number with no mitigation:  ", job_id_none)
print("job number with ZNE  ", job_id_zne)
print("job number with PEC  ", job_id_pec)
job number with no mitigation:   d7uc79back5s73be1cv0
job number with ZNE   d7uc7c3ack5s73be1d40
job number with PEC   d7uc9k4inasc738smhu0
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
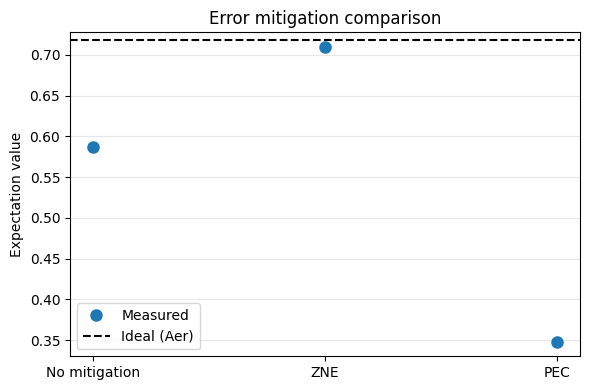
PEC bukan sahaja mengambil masa yang jauh lebih lama daripada pilihan lain, malah kita jelas mencapai ambang overhed maksimum kita. Keputusan PEC telah membayar harga overhed, tetapi had overhed menghalang pembatalan model hingar yang dipelajari dengan ketepatan yang mencukupi. Ini sangat penting. Pada enam qubit, kita dapat memanfaatkan PEC dan mendapat keputusan yang lebih baik dengan peningkatan overhed kuantum yang sederhana sahaja (kira-kira faktor 5). Pada 30 qubit, kita membayar harga yang jauh lebih tinggi (kira-kira 60 kali lebih tinggi) dan keputusannya malah lebih teruk daripada anggaran tanpa pengurangan. Ini tidak bermakna PEC tidak boleh berfungsi dengan 30 qubit; itu mungkin bergantung pada litar. Mesejnya hanyalah bahawa pertumbuhan eksponen dalam overhed kuantum menyukarkan penjalanan untuk litar besar.
Perkara penting:
-
Pengurangan pengukuran selalunya membantu dan biasanya mempunyai overhed yang rendah: ia menghapuskan pincang yang tidak berskala dengan kedalaman litar dan ia bergabung dengan baik dengan hampir semua perkara.
-
Sesetengah teknik tidak boleh digabungkan. Walaupun boleh, pastikan anda menggabungkannya dengan cara yang konsisten supaya satu tidak membatalkan yang lain. Contoh yang baik ialah memastikan twirling dihidupkan semasa penentukuran untuk M3 jika kaedah tersebut hendak digabungkan.
-
PEC dan ZNE harus dianggap sebagai alternatif antara satu sama lain. Kedua-duanya menyelesaikan masalah yang sama dengan pertukaran yang bertentangan:
-
PEC: menghasilkan nilai jangkaan yang tidak berat sebelah dengan kos varians eksponen.
-
ZNE secara amnya menghasilkan pincang baki yang bergantung pada model ekstrapolasi, tetapi dengan kos yang sederhana.
-
-
DD boleh membantu untuk tempoh melahu yang panjang, tetapi ia membentuk semula model hingar dan boleh membatalkan andaian ekstrapolasi atau penyongsangan.
-
Pauli twirling tidak mengurangkan hingar. Ia membentuknya semula dan selalunya membolehkan teknik lain berfungsi dengan lebih baik (ZNE dan PEC).